
بطاقتا RTX 5060 Ti مقابل GB10: اختبار محلي لخمس نماذج ذكاء اصطناعي بسياق 256K
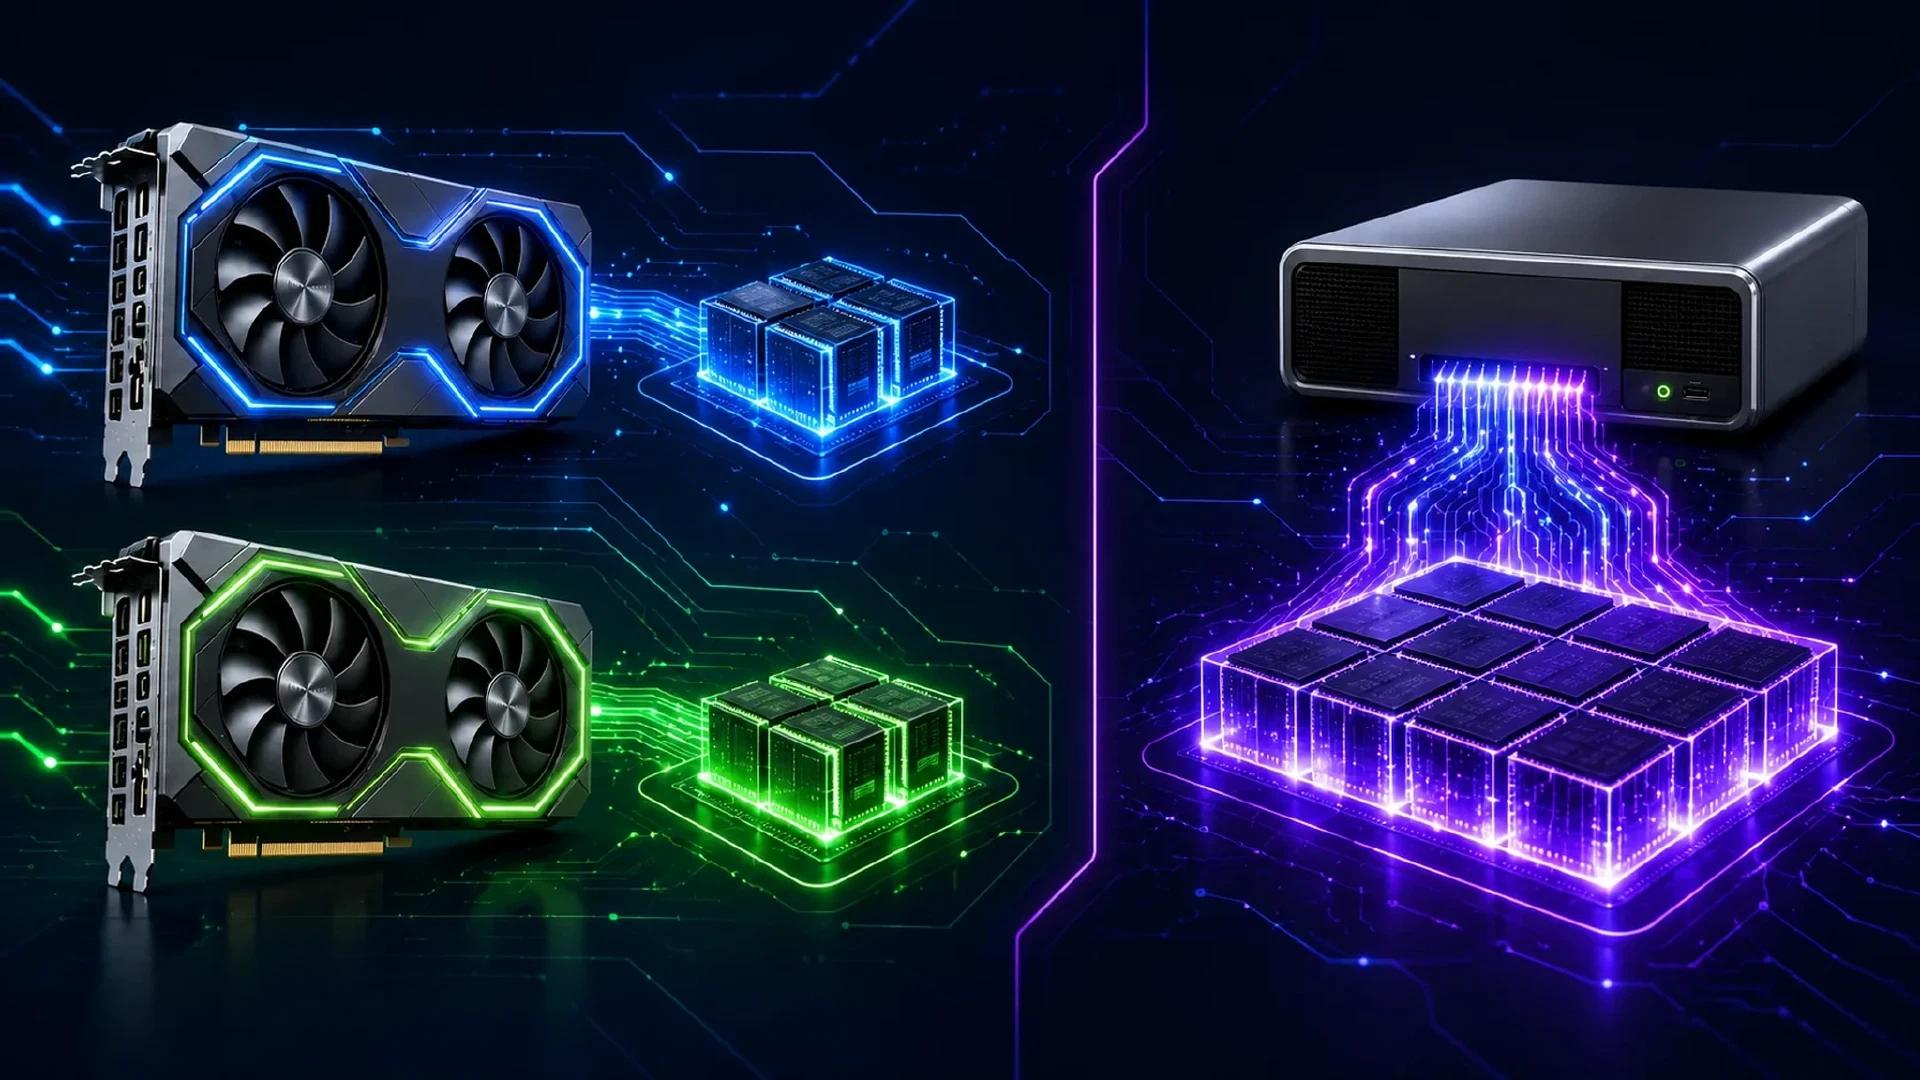
Table of Contents
توفر بطاقتا RTX 5060 Ti بسعة 16 GB لكل منهما إجمالي 32 GB من VRAM. ويقدم نظام NVIDIA GB10 ذاكرة موحدة متماسكة بسعة 128 GB. يعرض الاختبار الجديد لخمس نماذج نتيجة أكثر توازناً من الاختبار السابق الذي اقتصر على Qwen.
عند إعداد 256K، يتقدم النظام ذو البطاقتين في سرعة التوليد لأربع من النماذج الخمس. ويتفوق GB10 بوضوح على Qwen3.8 27B، مع إبقاء مساحة ذاكرة أكبر للنماذج والسياق وتخصيصات بيئة التشغيل. يعتمد الخيار الأنسب على النموذج وحمل العمل.
قارن اختبار منفصل على المضيف نفسه بين Qwen3.8-Flash-Next IQ2_XS على Strata وQwen3.8 27B Q4_K_M الكثيف على Ollama. بلغ وسيط التوليد بعد الإحماء 92.8 token في الثانية لـFlash-Next مع مطالبة من 260,446 token. وبلغ Qwen3.8 الكثيف 0.939 token في الثانية مع مطالبة من 260,444 token.
يستخدم NVIDIA GB10 ذاكرة موحدة متماسكة بسعة 128 GB. وتذكر NVIDIA أن منصة GB10 تضم ذاكرة موحدة LPDDR5x بسعة 128 GB وTDP للشريحة يبلغ 140 W. تحتوي كل بطاقة RTX 5060 Ti على 16 GB من GDDR7، وواجهة ذاكرة بعرض 128 بت، وقدرة رسومية إجمالية مصنفة عند 180 W. توضح مواصفات NVIDIA RTX 5060 Ti و مواصفات NVIDIA GB10 الفرق بين العتادين.
لا يعرض النظامان الذاكرة بالطريقة نفسها. تنشئ البطاقتان مجموعتين منفصلتين، سعة كل منهما 16 GB. ويضع GB10 النموذج وبيانات السياق ومخازن بيئة التشغيل وتخصيصات نظام التشغيل في مساحة عناوين مشتركة واحدة.
مقارنة الذاكرة
| النظام | الذاكرة | نموذج الذاكرة | القدرة المعلنة |
|---|---|---|---|
| بطاقتا RTX 5060 Ti بسعة 16 GB | 32 GB إجمالاً | مجموعتان منفصلتان لذاكرة GPU | 360 W إجمالي GPU |
| نظام GB10 | 128 GB | ذاكرة نظام موحدة متماسكة | TDP لـGB10: 140 W |
لا يفوز GB10 في كل اختبارات معدل النقل، إذ لا تضاهي ذاكرة LPDDR5x نطاق تردد بطاقات GPU المنفصلة. تنبع ميزته من السعة وطريقة التوزيع. يشترك CPU وGPU في مساحة العناوين نفسها، لذلك لا يلزم حصر مجموعة العمل في جهازين منفصلين بسعة 16 GB لكل منهما.
يواجه النظام ذو البطاقتين تحدياً في توزيع البيانات. يجب تقسيم النموذج بين البطاقتين، وعلى بيئة التشغيل نقل البيانات بينهما. تضيف حركة PCIe زمناً للتأخير وتستهلك نطاقاً ترددياً. ووفقاً لمواصفات NVIDIA، لا تدعم RTX 5060 Ti أيضاً NVLink.
اختبار النماذج الخمسة
استخدم الاختبار المحدث مصفوفة الطلبات نفسها على النظامين. وشمل خمس نماذج Ollama عند إعدادات سياق 4K و16K و32K و64K و128K و256K. ولّد كل طلب 128 token عند درجة حرارة 0.
كانت وسوم النماذج المختبرة:
- Qwen3.8 27B:
qwen3.8:27b - GPT-OSS 20B:
gpt-oss:20b - Qwen3.6 35B-A3B:
qwen3.6:35b - Qwen3.5 35B-A3B:
qwen3.5:35b-a3b-q4_K_M - Nemotron 3.5 Lightning 30B-A3B:
nemotron-3.5-lightning:30b-a3b-q4_K_M
استخدم نظام البطاقتين بطاقتي RTX 5060 Ti بسعة 16 GB لكل منهما. واستخدم GB10 ذاكرة موحدة بسعة 128 GB. شغّلت الاختبارات Ollama، بالإصدار 0.34.2 على نظام البطاقتين والإصدار 0.40.2 على GB10.
سرعة التوليد
تقيس سرعة التوليد عدد الرموز الناتجة بعد معالجة المطالبة. ويكتسب هذا المقياس أهمية خاصة أثناء المحادثة التفاعلية.
نظام ببطاقتي RTX 5060 Ti:
| السياق | GPT-OSS 20B | Nemotron 3.5 | Qwen3.5 35B | Qwen3.6 35B | Qwen3.8 27B |
|---|---|---|---|---|---|
| 4K | 91.518 | 162.027 | 117.547 | 156.104 | 55.654 |
| 16K | 87.176 | 161.377 | 112.903 | 140.596 | 51.656 |
| 32K | 82.372 | 157.055 | 106.455 | 144.833 | 47.369 |
| 64K | 74.661 | 135.106 | 95.979 | 125.008 | 38.863 |
| 128K | 62.767 | 130.924 | 79.572 | 115.352 | 26.399 |
| 256K | 67.853 | 106.221 | 58.947 | 67.159 | 1.079 |
GB10:
| السياق | GPT-OSS 20B | Nemotron 3.5 | Qwen3.5 35B | Qwen3.6 35B | Qwen3.8 27B |
|---|---|---|---|---|---|
| 4K | 62.199 | 98.648 | 72.405 | 100.906 | 32.985 |
| 16K | 56.764 | 94.366 | 69.782 | 95.448 | 32.939 |
| 32K | 53.257 | 98.175 | 64.055 | 95.025 | 29.772 |
| 64K | 49.201 | 96.132 | 58.428 | 84.528 | 25.625 |
| 128K | 40.637 | 80.238 | 48.108 | 74.579 | 22.294 |
| 256K | 43.688 | 68.043 | 36.649 | 62.115 | 22.371 |
عند 256K، ولّد نظام البطاقتين بسرعة أكبر مع GPT-OSS وNemotron وQwen3.5 وQwen3.6. وتفوق GB10 بفارق كبير مع Qwen3.8؛ إذ انخفض النظام ذو البطاقتين إلى 1.079 token في الثانية، بينما أنتج GB10 مقدار 22.371 token في الثانية.
النتيجة متقاربة مع Qwen3.6. بلغ نظام البطاقتين 67.159 token في الثانية، وبلغ GB10 مقدار 62.115. لا تدعم هذه النتيجة تعميماً يفيد بأن الذاكرة الموحدة تفوز دائماً أو أن بطاقتي GPU منفصلتين تفوزان دائماً.
سرعة معالجة المطالبة
تقيس معالجة المطالبة سرعة قراءة بيئة التشغيل للسياق المدخل قبل التوليد. وتهم هذه السرعة مع المستندات الطويلة وإعادة تحميل السياق مراراً.
نظام ببطاقتي RTX 5060 Ti:
| السياق | GPT-OSS 20B | Nemotron 3.5 | Qwen3.5 35B | Qwen3.6 35B | Qwen3.8 27B |
|---|---|---|---|---|---|
| 4K | 4745.9 | 2409.0 | 2701.7 | 464.3 | 783.9 |
| 16K | 7617.0 | 3031.8 | 4175.3 | 2654.0 | 840.1 |
| 32K | 8099.5 | 3074.2 | 4335.8 | 2623.2 | 811.2 |
| 64K | 6809.5 | 2893.0 | 4129.9 | 2400.4 | 727.8 |
| 128K | 5089.9 | 2362.7 | 3084.0 | 1723.6 | 546.1 |
| 256K | 5838.3 | 1813.2 | 2229.1 | 1011.0 | 251.3 |
GB10:
| السياق | GPT-OSS 20B | Nemotron 3.5 | Qwen3.5 35B | Qwen3.6 35B | Qwen3.8 27B |
|---|---|---|---|---|---|
| 4K | 3295.5 | 576.0 | 2067.9 | 628.8 | 756.9 |
| 16K | 4675.5 | 3006.7 | 2691.2 | 2556.3 | 812.6 |
| 32K | 4571.4 | 3077.9 | 2691.7 | 2563.9 | 794.1 |
| 64K | 3704.7 | 3066.9 | 2585.3 | 2444.9 | 714.0 |
| 128K | 2857.0 | 2802.9 | 2360.4 | 2229.9 | 655.5 |
| 256K | 3243.4 | 2325.4 | 1938.5 | 1817.6 | 535.1 |
عند 256K، تقدم نظام البطاقتين في معالجة مطالبات GPT-OSS وQwen3.5. وتقدم GB10 مع Nemotron وQwen3.6 وQwen3.8. تهم بنية النموذج وسلوك بيئة التشغيل بقدر أهمية واجهة الذاكرة.
اختبارات إضافية لـQwen3.8 Flash-Next
قاست ثلاثة اختبارات إضافية حزم Qwen3.8 Flash-Next بصيغة GGUF على نظام RTX 5060 Ti ذي البطاقتين عند سياقي 4K و16K. يرد مرجع النموذج الدقيق في Hugging Face ونوع التكميم في كل صف.
| النموذج الدقيق | التكميم | التوليد عند 4K | التوليد عند 16K |
|---|---|---|---|
hf.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF:IQ2_XS | IQ2_XS | 31.77 tok/s | 28.20 tok/s |
hf.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF:IQ3_S | IQ3_S | 24.54 tok/s | 22.60 tok/s |
hf.co/orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF:Q4_K_M | Q4_K_M | 17.91 tok/s | 17.02 tok/s |
حققت حزمة IQ2_XS أعلى معدل نقل في هذه المجموعة: 31.77 token في الثانية عند 4K، مقابل 24.54 لـIQ3_S و17.91 لـQ4_K_M. واستمر الترتيب نفسه عند 16K: 28.20 و22.60 و17.02 token في الثانية.
شغّل مراجع النماذج نفسها تماماً باستخدام Ollama:
ollama run hf.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF:IQ2_XS
ollama run hf.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF:IQ3_S
ollama run hf.co/orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF:Q4_K_M
تمثل هذه النتائج الإضافية السابقة ملاحظات من نظام ذي بطاقتي GPU. وهي منفصلة عن مصفوفة الطلبات المطابقة بين RTX 5060 Ti وGB10 أعلاه. يحدد السجل المتاح مراجع النماذج الدقيقة والتكميم وإعدادات السياق المطلوبة وسرعة التوليد. لكنه لا يتضمن بصمات manifest المحلولة، أو عدد رموز المطالبة المعالجة، أو طول المخرجات، أو حالة الإحماء، أو تقسيم الأجهزة، أو CPU، أو RAM النظام، أو التبريد، أو تاريخ القياس.
مقارنة Strata وOllama الكثيف عند 256K
قارن اختبار ثانٍ بتاريخ 14 أكتوبر 2026 بين مجموعتين من النماذج وبيئات التشغيل على مضيف واحد مزود ببطاقتي RTX 5060 Ti. استخدم خط الأساس الكثيف
qwen3.8:27b
، وهو نموذج Qwen35 يحوي 27.3 مليار معامل بتكميم Q4_K_M. واستخدمت مجموعة Flash نموذج Qwen4Exp من نوع mixture-of-experts، وهو
Qwen3.8-Flash-Next IQ2_XS
، ضمن حزمة Strata أصلية موحدة.
هذه مقارنة على مستوى مجموعة التشغيل بأكملها. تغيرت بنية النموذج والتكميم والتغليف وتوجيه الخبراء ومحرك الاستدلال معاً. لم تشمل هذه الجولة نسختي Flash IQ3_S وQ4_K_M.
نظام الاختبار ومنهجيته
| المكوّن | الإعداد المسجل |
|---|---|
| GPU | 2x NVIDIA GeForce RTX 5060 Ti، بسعة 16 GiB لكل بطاقة، compute capability 12.0 |
| اتصال GPU | PCIe 4.0 x4 لكل بطاقة، طوبولوجيا PHB، دون NVLink |
| CPU | AMD Ryzen 9 5900XT، 32 مساراً |
| ذاكرة المضيف | 62 GiB RAM و15 GiB swap |
| برنامج تشغيل NVIDIA | 595.99.02 |
أنشأ برنامج الاختبار سجلات اصطناعية مرقمة. اتبع كل صف التنسيق Record 00001: alpha beta gamma delta epsilon zeta eta theta iota kappa. واشترطت التعليمات وضع BENCHMARK_OK أولاً، ثم تقديم خلاصة تقنية موجزة حتى حد المخرجات. احتوت المطالبات الست على 180 و720 و1,500 و3,100 و6,200 و12,400 سجل.
استخدم كل تشغيل درجة حرارة 0 وseed بقيمة 42 وحداً أقصى للمخرجات يبلغ 128 token. سبق خمسَ طلبات مقاسة عند كل سياق تشغيلُ إحماء واحد. استخدمت اختبارات Ollama المسار /api/generate، واستخدمت اختبارات Strata المسار /v1/chat/completions. اكتملت جميع الطلبات المقاسة دون أخطاء API.
لم تتطابق إعدادات فك الترميز. ضبطت Strata الخيار reasoning_effort صراحة على none وعطلت التفكير عبر قالب المحادثة. ولم يرسل طلب Ollama للنموذج الكثيف think: false، كما أظهر فحص لاحق مخرجات النموذج الكثيف في حقلي التفكير والاستجابة. اعتبر نتيجة التوليد خاصة بنمطي فك الترميز هذين.
| إعداد السياق | رموز مطالبة Dense | رموز مطالبة Flash |
|---|---|---|
| 4K | 3,824 | 3,826 |
| 16K | 15,164 | 15,166 |
| 32K | 31,544 | 31,546 |
| 64K | 65,144 | 65,146 |
| 128K | 130,244 | 130,246 |
| 256K | 260,444 | 260,446 |
أعلن رأسا النموذجين حداً أقصى للسياق يبلغ 262,144 token. واختلفت المطالبات المقترنة برمزين عند كل نقطة قياس.
وسيط سرعة التوليد بعد الإحماء
يشمل كل وسيط خمسة طلبات مقاسة بعد إحماء واحد. أعاد كل طلب Dense مقاس استخدام كل رموز المطالبة باستثناء أربعة، وكل طلب Flash باستثناء سبعة. يقيس الجدول معدل فك الترميز بعد الإحماء مع تخزين البادئة مؤقتاً، ولا يقيس زمن الاستجابة الشامل في حالة باردة.
| السياق | Flash IQ2_XS على Strata | Dense Q4_K_M على Ollama | تفوق Flash |
|---|---|---|---|
| 4K | 98.4 tok/s | 65.0 tok/s | 1.51x |
| 16K | 96.8 tok/s | 60.6 tok/s | 1.60x |
| 32K | 95.3 tok/s | 64.4 tok/s | 1.48x |
| 64K | 89.6 tok/s | 51.2 tok/s | 1.75x |
| 128K | 92.9 tok/s | 31.5 tok/s | 2.95x |
| 256K | 92.8 tok/s | 0.939 tok/s | 98.9x |
حافظت مجموعة Flash على سرعة تقارب 90 token في الثانية من 64K إلى 256K. وتباطأ Qwen3.8 الكثيف بشدة بعد 64K، وبلغ 0.939 token في الثانية عند 256K. انتهت استجابة Flash عند 256K بصورة طبيعية بعد 67 token. ووصل تشغيل Dense إلى حد المخرجات البالغ 128 token.
معالجة المطالبة في الطلب الأول
| السياق | طلب Flash الأول | طلب Dense الأول |
|---|---|---|
| 4K | 1,134 tok/s | 832 tok/s |
| 16K | 2,013 tok/s | 856 tok/s |
| 32K | 2,386 tok/s | 799 tok/s |
| 64K | 2,509 tok/s | 690 tok/s |
| 128K | 2,538 tok/s | 489 tok/s |
| 256K | 2,399 tok/s | 214 tok/s |
عالج طلب Dense الأول المطالبة كاملة عند كل نقطة قياس. وأبلغت Strata عن إعادة استخدام 16,384 token من البادئة عند 64K، و49,152 عند 128K، و114,688 عند 256K. اعتبر سرعات Flash من 64K إلى 256K معدل نقل لاستكمال الطلب الأول، لا معالجة تمهيدية كاملة دون ذاكرة مؤقتة.
عند 256K، عالجت Strata الطلب الأول خلال 60.8 ثانية. واستغرقت Ollama نحو 1,215.4 ثانية. تمنع إعادة استخدام البادئة إجراء مقارنة مباشرة للمعالجة التمهيدية الباردة عند هذه النقطة.
يفسر توزيع بيئة التشغيل الفارق في السياق الطويل
استخدمت Ollama 0.34.2 البرنامج llama-server 0.4.1-dev مع إلغاء تحميل طبقات CUDA وقالب ChatML وفك الترميز التخميني MTP بعرض مسودة أقصى قدره أربعة. بلغ حجم batch وmicrobatch مقدار 1,024 عند 32K و512 من 64K إلى 256K. بقيت الطبقات الكثيفة الست والستون على GPU عند 32K و64K. عند 128K، بقيت 63 طبقة من أصل 66 على GPU وانتقل 1,404 MiB إلى ذاكرة مرتبطة بـCPU. وعند 256K بقيت 42 طبقة على GPU وانتقل 6,002 MiB إلى ذاكرة مرتبطة بـCPU. بلغت نسبة قبول MTP عند 256K نحو 69.4 بالمئة.
أبقت Strata 0.1.44.1 مع CUDA 13.0.3 طبقاتها الـ48 مقسمة بين بطاقتي GPU. وضعت إعدادات 4K و16K الطبقات من 0 إلى 23 على GPU الأول، والطبقات من 24 إلى 47 على الثاني. استخدمت هذه الجولة احتياطياً تلقائياً قدره 700 MiB من VRAM و16,047 خانة خبراء مقيمة.
وضعت إعدادات 32K إلى 256K الطبقات من 0 إلى 24 على GPU الأول، ومن 25 إلى 47 على الثاني. استخدمت هذه الجولة prefill تلقائياً، واحتمالاً تخمينياً أدنى قدره 0.5، وتخزين KV بصيغة INT8، و32,768 خلية KV مقيمة لكل طبقة QSA، واحتياطياً لـVRAM قدره 832 MiB، وذاكرة خبراء مؤقتة تضم 15,318 خانة و21,024 MiB، وفك الترميز التخميني MTP بعرض مسودة أقصى قدره أربعة.
كانت بصمة blob الأصلي في Strata وPLE هي sha256:1473e0664c2017095f9164b6d617d7a71893452c1180c83002c4f28fc8c2b0da. واعتمد التشغيل أيضاً على ملف تعريف للخبراء وحزمة مسودات MTP دون بصمات ثابتة منشورة.
استخدم تشغيل Strata وضع تخطي ذيل المسار الافتراضي. يغير هذا الإعداد مخرجات النموذج قليلاً، ويجعل النتيجة خاصة بإعداد بيئة التشغيل المسجل. حملت استجابات Flash علامات BENCHMARK_OK. ولم تُرجع طلبات Dense أخطاء API، لكن برنامج الاختبار الرئيسي لم يلتقط العلامة، وسجلت صفوفه الخام صفراً من أحرف الاستجابة. عثر فحص لاحق على مخرجات في حقلي response وthinking وأكد وجود BENCHMARK_OK في الاستجابة.
سجل إعداد 4K و16K طلباً واحداً مع 409 MiB حرة، وأوصى باحتياطي 832 MiB. وسجل إعداد السياق الطويل طلباً واحداً مع 481 MiB حرة، وأوصى باحتياطي 896 MiB. تقل القيمتان عن عتبة ترحيل برنامج التشغيل البالغة 512 MiB. لم يفشل أي طلب، لكن انخفاض الذاكرة يؤثر في قابلية تكرار النتائج.
تعامل مع قيمة 98.9x على أنها نتيجة للسياق الطويل للمجموعة كاملة، لا دليلاً على تفوق المحرك وحده بمقدار 98.9 مرة. يعزل الاختبار المضيف، لكنه لا يعزل النموذج أو التكميم أو بيئة التشغيل.
الطول الفعلي للمطالبة مهم
لا يساوي إعداد السياق المطلوب عدد رموز المطالبة التي تمت معالجتها. عند إعداد 256K، عالجت اختبارات Qwen3.5 وQwen3.6 وNemotron وQwen3.8 نحو 171,359 إلى 171,365 token فعلياً على النظامين.
عالج GPT-OSS مقدار 65,538 token فعلياً عند إعداد 256K على النظامين. لذلك لا يمثل صفه عند 256K طول الإدخال نفسه للنماذج الأخرى.
تظهر نتيجة Qwen3.8 عند 256K أوضح فرق. عالج نظام البطاقتين 171,359 token من المطالبة بسرعة 251.3 token في الثانية، ثم ولّد بسرعة 1.079 token في الثانية. وعالج GB10 العدد نفسه من رموز المطالبة بسرعة 535.1 token في الثانية، ثم ولّد بسرعة 22.371 token في الثانية.
يحدد إعداد السياق الحد المطلوب. ويبين العدد الفعلي لرموز المطالبة حمل العمل الذي أكملته بيئة التشغيل.
لماذا تظل سعة VRAM الإجمالية مهمة
1. لا يرى النموذج بطاقة واحدة بسعة 32 GB
لا يدمج GPUان ذاكرتهما في مساحة عناوين محلية واحدة. توزع بيئة تشغيل model-parallel الطبقات أو الموترات بين الأجهزة. ويظل كل جهاز بحاجة إلى مساحة للأوزان المخصصة له والمخازن المؤقتة وجزء من حالة السياق.
السعة القابلة للاستخدام أقل مما يوحي به الجمع البسيط. يعتمد العبء الإضافي الدقيق على تنسيق النموذج والتكميم وواجهة الاستدلال الخلفية وتقسيم الموترات وطول السياق.
2. تزداد ذاكرة السياق أثناء التوليد
لا تمثل أوزان النموذج سوى جزء من ميزانية الذاكرة. تخزن ذاكرة key-value المؤقتة، أو KV cache، بيانات attention للرموز السابقة. تتطلب السياقات الأطول ذاكرة مؤقتة أكبر. ولا يتنبأ اختبار 4K بأداء تشغيل عند 128K أو 256K.
تظهر النتائج الجديدة نقاط انهيار مختلفة بحسب النموذج. يتعرض Qwen3.8 لانخفاض حاد في التوليد على نظام البطاقتين عند 256K. وتحافظ النماذج الأربعة الأخرى على سرعة توليد قابلة للاستخدام على النظامين. تظل سعة الذاكرة مهمة لأنها تحدد تركيبات النموذج والسياق التي تتسع مع تخصيصات بيئة التشغيل.
3. تضيف عمليات نقل PCIe كلفة
عندما تنقل بيئة التشغيل التنشيطات أو الموترات بين بطاقات GPU، تعبر البيانات وصلة المضيف. وينشئ ذلك نقاط مزامنة ويضيف تأخيراً لكل خطوة. تعتمد الكلفة على موضع الموترات وبنية النموذج والتكميم وطول السياق.
لا يجعل ذلك نظام GPU مزدوجاً بلا فائدة. بل يعني أن إعداد بيئة التشغيل والنموذج يحددان النتيجة. ويتجاهل الاختبار الذي يعرض معالجة المطالبة عند 4K فقط هذه الكلفة.
4. تظل كفاءة الطاقة ميزة على مستوى النظام
يوفر GB10 سعة ذاكرة أكبر مع قدرة معلنة أقل للشريحة أو GPU. تبلغ القدرة المجمعة لبطاقتي RTX 5060 Ti مقدار 360 W قبل احتساب بقية النظام. وتذكر NVIDIA أن TDP لـGB10 يبلغ 140 W.
يتنازل GB10 عن ذروة معدل النقل في عدة نماذج مقابل السعة ومجموعة عمل مشتركة وقدرة GPU معلنة أقل. ويحقق نظام البطاقتين معدل نقل مقاساً أعلى في عدة نماذج MoE أحدث.
تكلفة نظام 5060ti-x2 أقل بكثير
بلغ سعر محطة عمل كاملة ببطاقتي RTX 5060 Ti سعة 16 GB $3,479 في عرض 10 أكتوبر 2026. يشمل التكوين Intel Ultra 7 265K ولوحة Z890 وذاكرة DDR5 بسعة 32 GB وتخزيناً بسعة 1 TB ومزود طاقة 1,000 W والبطاقتين. اعرض قائمة مكونات محطة العمل الكاملة ذات بطاقتي GPU .
يعرض متجر NVIDIA الأمريكي DGX Spark بسعة 128 GB مقابل $6,950. يتضمن العرض ذاكرة موحدة متماسكة بسعة 128 GB وتخزين NVMe بسعة 4 TB، لكن النظام غير متوفر حالياً. تحقق من عرض DGX Spark الحالي لدى NVIDIA .
توفر منصة المطورين AMD Ryzen AI Halo نقطة مقارنة أخرى. يبلغ سعر نظام Strix Halo هذا $3,999.99 في Micro Center، مع ذاكرة موحدة LPDDR5x بسعة 128 GB وتخزين 2 TB. يقع Strix Halo غالباً ضمن الفئة العملية نفسها لأنظمة GB10 للذكاء الاصطناعي المحلي، رغم أن الاختبارات المستقلة كثيراً ما تقيس تفوق GB10 في معدل النقل ونضج البرمجيات. تحقق من عرض Linux الحالي في Micro Center و اقرأ مراجعة Strix Halo مقابل GB10 .
| النظام الكامل | السعر المعروض في 10 أكتوبر 2026 | فرق السعر |
|---|---|---|
| محطة عمل 5060ti-x2 | $3,479 | السعر الأساسي |
| AMD Ryzen AI Halo، Strix Halo | $3,999.99 | أعلى بـ$520.99 |
| 128 GB GB10 DGX Spark | $6,950 | أعلى بـ$3,471 |
يوفر GB10 مجموعة ذاكرة موحدة أكبر وقدرة GPU معلنة أقل. ويوفر نظام AMD فئة الذاكرة نفسها بسعة 128 GB مقابل نحو $4,000. تظل محطة 5060ti-x2 بسعر يقارب 50% من السعر المعروض لـGB10 قبل الضرائب والشحن.
هذه أسعار معلنة لدى بائعين مختلفين، وليست مقارنة لسلة شراء موحدة. كما أن نظام 5060ti-x2 يضم ذاكرة نظام وتخزيناً أقل. تتراوح عروض بطاقات RTX 5060 Ti سعة 16 GB حالياً بين $789 و$830 للبطاقة، وهي أعلى بكثير من سعر الإطلاق المقترح البالغ $429. لذلك تستمر ميزة السعر لنظام البطاقتين خلال الارتفاع الحالي في أسعار GPU. تحقق من أسعار RTX 5060 Ti الحالية .
ما يعنيه ذلك لأحمال الذكاء الاصطناعي المحلية
يشغّل إعداد بطاقتين بسعة 16 GB عدة نماذج مكممة بحجم 27B إلى 35B ضمن سياقات طويلة. ولا يحدد الاختبار فائزاً واحداً لكل النماذج.
اختر نظام البطاقتين إذا كانت أولويتك:
- سرعة توليد أعلى مع GPT-OSS وNemotron وQwen3.5 وQwen3.6 في هذا الاختبار.
- معدل نقل أعلى مع السياق القصير عبر النماذج الخمسة.
- تكلفة شراء أقل من نظام GB10 المعروض.
- توافق البرمجيات مع بطاقات NVIDIA المنفصلة وإمكانية تجربة نماذج لاحقة.
اختر GB10 إذا كانت أولويتك:
- Qwen3.8 27B عند 256K، إذ يولد GB10 بسرعة تزيد على 20 ضعفاً.
- مجموعة ذاكرة واحدة بسعة 128 GB توفر مساحة أكبر لأوزان النموذج وذاكرة KV المؤقتة ومخازن بيئة التشغيل.
- قدرة GPU أو شريحة معلنة أقل من بطاقتين منفصلتين.
- قيود أقل على التوزيع بين الأجهزة للنماذج التي تضغط على إعداد البطاقتين.
يتوافق ذلك مع إرشادات تحديد السعة في هل تكفي 16 GB من VRAM للعمل الجاد مع نماذج LLM المحلية؟ ، التي تجمع الأوزان والسياق وتخصيصات بيئة التشغيل ضمن ميزانية واحدة. ويصل دليل 32 GB من VRAM لـQwen 27B إلى النتيجة نفسها لإعدادات البطاقتين. لا تساوي السعة الإجمالية الهامش المتاح للاستخدام.
قبل شراء العتاد لأي تشغيل بسياق طويل، اطرح أربعة أسئلة:
- هل يتسع التكميم المطلوب مع مخازن بيئة التشغيل؟ لا تحدد أوزان النموذج وحدها متطلبات الذاكرة.
- هل يتسع السياق دون ضغط شديد على ذاكرة KV المؤقتة؟ تغير المطالبات الطويلة النتيجة.
- هل توزع بيئة التشغيل العمل بكفاءة بين الأجهزة؟ تؤثر عمليات PCIe ومواضع الموترات في كل token مولد.
- هل يكمل النظام السياق المستهدف؟ لا تعوض نتيجة 4K السريعة فشل حمل 256K.
يجيب الاختبار الجديد عن هذه الأسئلة لكل نموذج على حدة. يفضل Qwen3.8 نظام GB10 بوضوح عند 256K. أما النماذج الأربعة الأخرى فتفضل نظام البطاقتين من حيث سرعة التوليد في هذا الإعداد تحديداً. وتظل مجموعة الذاكرة الموحدة الأكبر توفر سعة احتياطية أكبر، حتى إن لم تحقق أعلى معدل نقل مقاس.
سجل العتاد نفسه ذو بطاقتي GPU أيضاً وسيطاً بعد الإحماء قدره 92.8 token في الثانية عند 256K مع Flash-Next IQ2_XS على Strata. لا تغير هذه النتيجة المنفصلة استنتاج Qwen3.8 الكثيف على GB10. يستخدم Flash-Next بنية mixture-of-experts وتكميماً وحزمة وبيئة تشغيل ونمط فك ترميز مختلفاً. لا تتضمن مجموعة البيانات نتيجة Flash-Next مطابقة على GB10.
الخلاصة
يولد نظام RTX 5060 Ti ذي البطاقتين بسرعة أكبر لأربع من النماذج الخمسة المختبرة عند 256K. كما أن تكلفته تقارب نصف سعر نظام GB10 المعروض. يظل GB10 الخيار الأفضل لـQwen3.8 27B عند 256K، وللحصول على هامش سعة أكبر، ولأحمال العمل التي تستفيد من مجموعة ذاكرة متماسكة واحدة.
أشارت النتيجة السابقة التي اقتصرت على Qwen إلى فوز واضح لـGB10. ويوضح الاختبار المحدث لخمس نماذج سبب اتساع ذلك الاستنتاج أكثر مما ينبغي. تؤثر بنية النموذج وإصدار بيئة التشغيل وموضع الموترات وسلوك السياق في النتيجة.
إذا كنت تشغل GPT-OSS أو Nemotron 3.5 Lightning أو Qwen3.5 أو Qwen3.6، فقد حقق نظام البطاقتين سرعة توليد أعلى في هذا الاختبار. أما عند تشغيل Qwen3.8 27B بسياق 256K، فقد حافظ GB10 على سرعة توليد عملية بينما كاد نظام البطاقتين يتوقف.
سعة الذاكرة ومعدل النقل معياران منفصلان للشراء. يقدم GB10 أربعة أضعاف الذاكرة الإجمالية ومجموعة عمل مشتركة أبسط. ويوفر نظام البطاقتين معدل نقل ملاحظاً أعلى في معظم النماذج المختبرة بسعر نظام أقل بكثير وفق العرض.
تضيف نتيجة Strata درساً آخر. غيّر توزيع بيئة التشغيل وبنية النموذج ونمط فك الترميز نتيجة 256K على المضيف نفسه ذي البطاقتين. حافظ Flash-Next IQ2_XS على وسيط يقارب 93 token في الثانية بعد الإحماء، بينما ألغى Qwen3.8 الكثيف تحميل 24 طبقة وانخفض إلى أقل من token واحد في الثانية.
حدود الاختبار
يسجل الاختبار وسوم النماذج والسياقات المطلوبة وعدد رموز المطالبة الفعلي وسرعة معالجة المطالبة والتوليد وإصدارات Ollama وهدف التوليد البالغ 128 token. ولا يسجل بصمات manifest المحلولة أو قدرة CPU أو استهلاك الطاقة من المقبس أو سرعة المراوح أو إعداد التبريد.
عالجت صفوف GPT-OSS عند 256K عدد 65,538 token فعلياً من المطالبة على النظامين. وعالجت الصفوف الأخرى عند 256K نحو 171K token فعلياً. تعامل مع الأرقام كمقارنة بين أنظمة تمت ملاحظتها، لا كترتيب عام لكل زوج RTX 5060 Ti ولكل تنفيذ GB10.
يسجل اختبار Strata مقابل النموذج الكثيف أعداد المطالبات الدقيقة وخمسة طلبات مقاسة لكل سياق وإصدارات بيئة التشغيل ومواضع الأجهزة وإعدادات الذاكرة المؤقتة وحالة الطلبات. يغير الاختبار بنية النموذج والتكميم والتغليف وبيئة التشغيل ونمط فك الترميز معاً. أعادت Strata استخدام بادئات المطالبات فوق 32K أيضاً. وأعادت طلبات التوليد المقاسة في المجموعتين استخدام المطالبة بأكملها تقريباً.
لا يمكن إعادة إنتاج الاختبار بدقة اعتماداً على هذا المقال. لم تنشر أداة الاختبار وتخطيط حزمة Strata وملف تعريف الخبراء وحزمة مسودات MTP ببصمات ثابتة. ويضيف تحذير انخفاض VRAM خطراً على ثبات النتائج بين التشغيلات. يعزل الاختبار المضيف، لا محرك الاستدلال.
مصدر مواصفات العتاد أعلاه هو NVIDIA. وتأتي أرقام الأداء من تشغيل اختبار مضبوط أُجري لهذا المقال.
المراجع
- مكتبة نماذج Qwen3.8 في Ollama
- نماذج ISTA-DASLab Qwen3.8 Flash-Next GSQ-RCO بصيغة GGUF
- نماذج orcarouter Qwen3.8 Flash-Next Uncensored بصيغة GGUF
- مكتبة نماذج Qwen3.5 في Ollama
- مكتبة نماذج Qwen3.6 في Ollama
- مكتبة نماذج Nemotron 3.5 Lightning في Ollama
- وسوم نماذج GPT-OSS في Ollama
- هل تكفي 16 GB من VRAM للعمل الجاد مع نماذج LLM المحلية؟
- 32 GB من VRAM لـQwen 27B
- دليل سياق نماذج الذكاء الاصطناعي المحلية وGPU
- اختبارات GPU لنموذج Qwen3.8 27B على Vast.ai
- عرض محطة العمل الكاملة ببطاقتي RTX 5060 Ti سعة 16 GB
- عرض NVIDIA DGX Spark في السوق الأمريكية
- عرض AMD Ryzen AI Halo بسعة 128 GB وLinux
- مراجعة Tom’s Hardware: Strix Halo مقابل GB10
- الأسعار الحالية لـRTX 5060 Ti
Related Posts