شهادات الأمن السيبراني للذكاء الاصطناعي: لا تواكب الممارسة

Table of Contents
دخلنا الاختبارات ونجحنا فيها. حصلنا على الشهادات، لكننا خرجنا أيضًا بخيبة أمل أريد وصفها بدقة.
هذه ليست شكوى من الأشخاص الذين وضعوا هذه البرامج. إنهم يعملون بمواد غير مكتملة. أمن الذكاء الاصطناعي مجال حديث. تتقدم أبحاث الهجوم أسرع من أدوات الدفاع. ظهرت أطر الحوكمة قبل الإرشادات الهندسية.
المشكلة هي الفجوة بين ما تعلمه الشهادات وما تحتاج إلى معرفته لتأمين أنظمة الذكاء الاصطناعي في بيئة الإنتاج فعلًا.
ثلاث طبقات يكثر الخلط بينها
قبل شرح ما ينقص، من المفيد فصل العناصر الموجودة حاليًا.
الطبقة الأولى هي الحوكمة. تعمل وثائق مثل NIST AI Risk Management Framework (AI RMF 1.0, 2023) وISO/IEC 42001:2023 وEU AI Act على مستوى المؤسسة والعمليات. وتشرح كيفية إدارة مخاطر الذكاء الاصطناعي، وبناء الرقابة، وتوثيق المساءلة. وهي تركز عمدًا على الحوكمة بدلًا من وصف ضوابط محددة. هذا مقصود في تصميمها.
الطبقة الثانية هي تصنيف التهديدات. يوثق MITRE ATLAS تكتيكات الخصوم ضد أنظمة الذكاء الاصطناعي بالتنسيق نفسه المستخدم في ATT&CK. ويسرد OWASP Top 10 for Large Language Model Applications فئات الهجوم الأهم على نماذج LLM المنشورة. تسمي هذه الوثائق الهجمات وتشرح آلية عملها، لكنها لا تفرض وسائل دفاع.
الطبقة الثالثة هي الإرشادات التقنية. وتشمل Google’s Secure AI Framework (SAIF) وMicrosoft’s AI Security SDL وOWASP AI Exchange وNIST AI 600-1 (Generative AI Profile) ووثائق أمنية خاصة بمورّدين مثل Anthropic وOpenAI وMeta. تقدم هذه المصادر إرشادات هندسية للنشر الآمن وممارسات التقييم وضوابط وقت التشغيل.
تغطي معظم شهادات حوكمة الذكاء الاصطناعي الطبقة الأولى بتفصيل. وتشير إلى الثانية بإيجاز، ونادرًا ما تتناول الثالثة.
ما تغطيه الشهادات
تغطي الشهادات المتاحة حاليًا في حوكمة الذكاء الاصطناعي وأمنه، ومنها IAPP AI Governance Professional (AIGP) وISACA AI Fundamentals Certificate وشهادات ISO 42001 وCompTIA AI+، مجموعة متشابهة من المواضيع.
تتعلم NIST AI RMF وكيفية ربط وظائفه الأربع Govern وMap وMeasure وManage بنشر الذكاء الاصطناعي في مؤسستك. وتتعلم تصنيفات المخاطر في EU AI Act وكيف يجري تقييم المطابقة للأنظمة عالية المخاطر. وتتعلم التحيز والإنصاف والشفافية والمساءلة بوصفها مبادئ للحوكمة. كما تتعلم كتابة سياسات حوكمة الذكاء الاصطناعي وإجراء تقييمات الأثر.
هذه مهارات حقيقية. تحتاج المؤسسات إلى أشخاص يفهمون أطر الحوكمة ويقرؤون NIST AI RMF ويدركون ما يطلب منهم بناءه.
لكن الشهادات لا تعلم بالعمق نفسه:
- كيف يخترق المهاجمون أنظمة الذكاء الاصطناعي في بيئة الإنتاج اليوم
- كيف يعمل الدفاع متعدد الطبقات ضد حقن الموجّه عمليًا، ولماذا لا يزيله ضابط واحد
- كيفية التحقق من سلامة النماذج قبل النشر
- ما الذي يتضمنه اختبار الفريق الأحمر للذكاء الاصطناعي وكيفية تحديد نطاقه
- كيفية تقييم سلوك النموذج أمام المدخلات الخصومية قبل الإطلاق
- شكل قابلية رصد الذكاء الاصطناعي أثناء الاستدلال
- كيف تختلف الاستجابة لحوادث الذكاء الاصطناعي عن أدلة IR القياسية
- متطلبات تأمين وكلاء الذكاء الاصطناعي ذوي الوصول إلى الأدوات والتكاملات الخارجية
NIST AI RMF للحوكمة لا للهندسة
NIST AI RMF وثيقة محكمة البناء. صممها NIST لتكون محايدة تقنيًا، وغير مقيدة بقطاع، وقابلة للتطبيق على مناهج تطوير مختلفة للذكاء الاصطناعي. وهذا يجعل الإطار واسع الاستخدام.
ويعني ذلك أيضًا أن الإطار لا يفرض ضوابط تقنية لفئات هجوم محددة. إذا تبنت مؤسستك AI RMF بالكامل وربطت جميع وظائفه بنشر الذكاء الاصطناعي لديها، فستمتلك عمليات مخاطر موثقة. لكن ذلك لا يضمن وجود دفاع ضد حقن الموجّه في نموذج اللغة المنشور.
يقر NIST بذلك. يوسع NIST AI 600-1، وهو Generative AI Profile الصادر في 2024، إطار AI RMF خصيصًا للذكاء الاصطناعي التوليدي ونماذج اللغة الكبيرة. ويغطي مخاطر مثل حقن الموجّه وتسميم البيانات ومخاطر المعلومات بمستوى من التفصيل لا يبلغه AI RMF الأساسي. إذا تناولت شهادتك AI RMF الأساسي من دون AI 600-1، فقد فاتك المستند الأكثر صلة بالأنظمة المنشورة حاليًا.
ISO 42001 ومقارنة نظام الإدارة
ISO 42001:2023 معيار لنظام إدارة الذكاء الاصطناعي. يوفر بنية لحوكمة تطوير الذكاء الاصطناعي ونشره على مستوى المؤسسة. وسيتعرف متخصصو الأمن على أوجه الشبه مع ISO 27001 لأمن المعلومات.
يشيع اعتماد ISO 27001، لكن المؤسسات المعتمدة تتعرض للاختراق أيضًا. توثق الشهادة وجود نظام إدارة، واتباعه لعملية محددة، ومراجعته. لكنها لا تثبت أن الأنظمة الخاضعة للعملية تقاوم الهجمات الموجهة إليها.
يوفر ISO 42001 انضباطًا مؤسسيًا. وتبين الشهادة للجهات المعنية أن عمليات الذكاء الاصطناعي موثقة ومراجعة وخاضعة للحوكمة. لكنها لا تثبت أن النماذج المنشورة تنتج مخرجات متسقة في ظروف خصومية، أو أن الوكلاء يعملون داخل حدود الثقة المحددة، أو أن النماذج المضبوطة دُربت على بيانات تدريب جرى التحقق منها.
هذه هي الفجوة نفسها الموجودة في ISO 27001. تعلمنا التعايش معها في الأمن السيبراني التقليدي. ولا ينبغي أن نتظاهر بأن شهادات حوكمة الذكاء الاصطناعي تسدها وهي تشترك في القيد البنيوي نفسه.
يفرض EU AI Act نتائج دون مواصفات هندسية
يصنف EU AI Act أنظمة الذكاء الاصطناعي حسب مستوى المخاطر: غير مقبول (محظور)، وعالٍ (يتطلب تقييم المطابقة)، ومحدود (التزامات شفافية)، وأدنى (لا متطلبات محددة).
تخضع الأنظمة عالية المخاطر، ومنها المستخدمة في البنية التحتية الحيوية والتعرف البيومتري وفرز المتقدمين للتوظيف والتعليم وإنفاذ القانون، لمتطلبات التوثيق التقني والإشراف البشري والمتانة. ويطلب القانون صراحة أن تقاوم أنظمة الذكاء الاصطناعي عالية المخاطر محاولات تغيير سلوكها بالتلاعب الخصومي.
هذا الشرط وارد في نص القانون. فهو يحدد النتائج عمدًا بدلًا من فرض ضوابط تقنية. ولم تُحسم بعد الطرق التقنية التي تثبت المتانة الخصومية في جميع سياقات النشر ولكل أنواع الأنظمة وحالات الاستخدام.
تؤهلك الشهادات المبنية على EU AI Act لتصنيف أنظمة الذكاء الاصطناعي وكتابة الوثائق التقنية وبناء بروتوكولات الإشراف. كما تؤهلك للتدقيق. لكن العمل الهندسي الذي ينتج نظامًا مستوفيًا لمتطلبات المتانة ينتمي إلى مجال مختلف عن المجالات التي تغطيها الشهادات الحالية.
ما الذي يهاجم أنظمة الذكاء الاصطناعي فعلًا
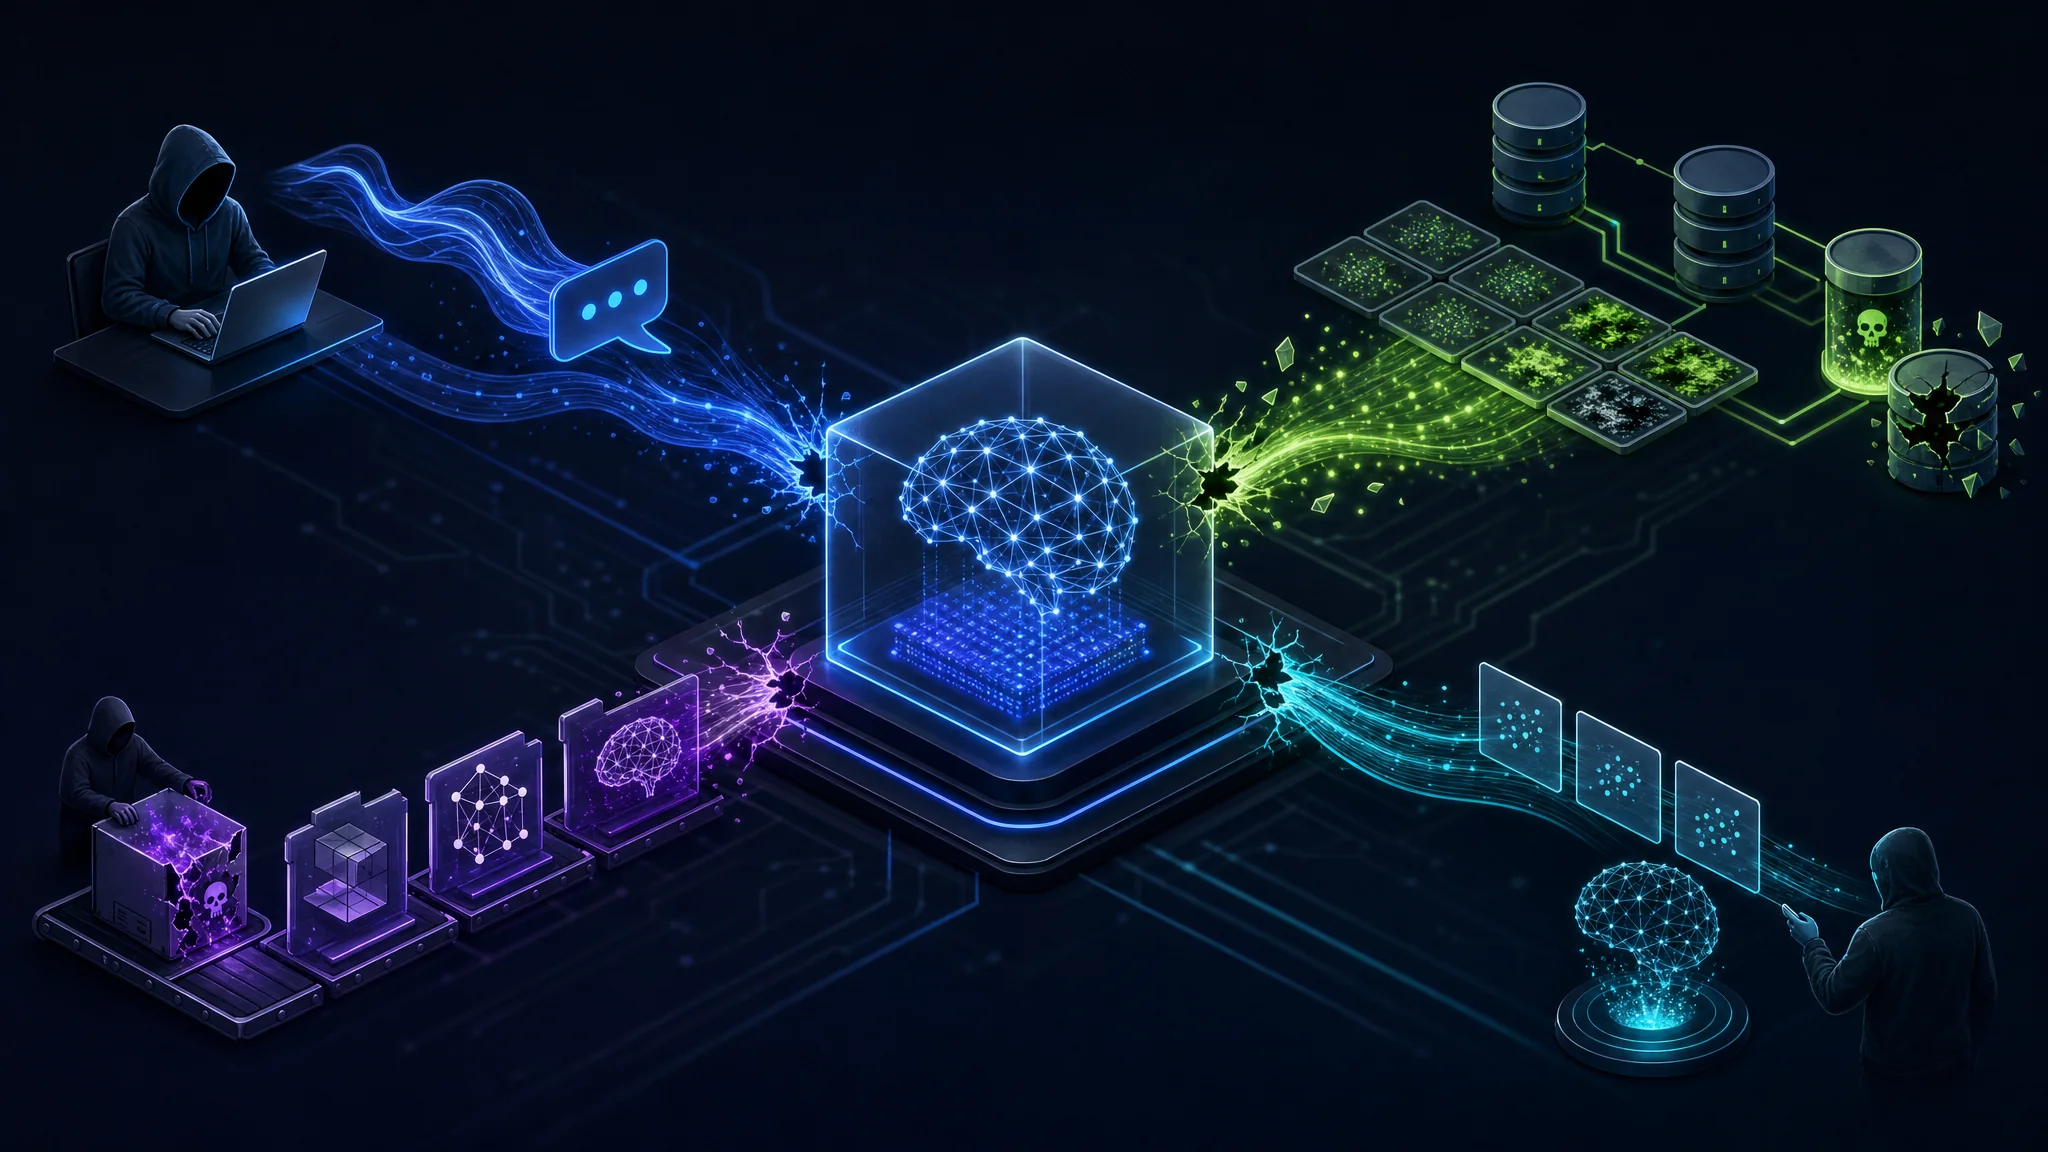
يوثق MITRE ATLAS وOWASP LLM Top 10 مشهد التهديدات التشغيلية. وهما مصدران يسردان الهجمات بمستوى مفيد من التفاصيل. أما أطر الحوكمة فتشير إلى التهديدات بصورة أكثر تجريدًا. والمعلومات التالية مأخوذة من هذه المصادر الأمنية المتخصصة.
يحدث حقن الموجّه بإعطاء نموذج اللغة مدخلًا يتجاوز تعليمات النظام أو يتلاعب بها. يستهدف الحقن المباشر مدخل النموذج نفسه. أما الحقن غير المباشر فيخفي تعليمات ضارة داخل محتوى يسترجعه النموذج أو يعالجه أو يلخصه. تقرأ منظومة RAG لديك مستندًا يتحكم فيه مهاجم وتنفذ التعليمات المخفية فيه. ويزور وكيل التصفح صفحة يتحكم فيها مهاجم ويتبع توجيهاتها المضمنة. ويلخص روبوت دعم العملاء مقالًا يطلب منه تجاهل إرشادات السلامة.
حتى 2026، لا يوجد تخفيف فعال عالميًا لحقن الموجّه. يخفض الدفاع متعدد الطبقات المخاطر عبر تصفية المدخلات والتحقق من المخرجات وتقييد صلاحيات الأدوات وعزل بيئات التنفيذ واشتراط موافقة بشرية على الإجراءات المهمة. ولا يلغي أي من ذلك فئة الهجوم. توصي NIST وOWASP وAnthropic وOpenAI وGoogle وMicrosoft بضوابط متعددة الطبقات بدلًا من حل واحد.
يدخل تسميم بيانات التدريب أمثلة ضارة في بيانات التدريب لتدهور سلوك النموذج أو إضافة أبواب خلفية أو زرع سلوكيات تنشط بمحفزات. وغالبًا لا تظهر إشارة تسميم ناجح حتى يواجه النموذج مدخلًا محفزًا محددًا. إذا ضبطت مؤسستك النماذج على محتوى أنشأه المستخدمون أو مستندات مسترجعة أو مجموعات بيانات من جهات خارجية من دون التحقق من مصدرها، فأنت معرض لهذا الخطر.
اختراق سلسلة توريد النماذج تهديد تتعامل معه مؤسسات كثيرة كأمر ثانوي. كثيرًا ما توزع مستودعات النماذج شيفرة قابلة للتنفيذ مع أوزان النماذج. وقد أنشأت صيغ التسلسل غير الآمنة مثل pickle مخاطر متكررة على سلسلة التوريد. وقد تثبت الحزم المصاحبة لتنزيل النماذج اعتماديات تحمل ثغرات خاصة بها. ويبدو أن مؤسسات كثيرة تدقق في النماذج من المستودعات العامة بدرجة أقل بكثير من تدقيقها في اعتماديات البرمجيات. سطح الهجوم مماثل لـ npm، لكن ثقافة الأمن حول النماذج ما زالت في بدايتها.
يسمح استخراج النموذج للمهاجمين بإعادة بناء نماذج مشابهة وظيفيًا عبر استعلامات استدلال متكررة إلى واجهة API لديك. وهذا يعني خسارة للملكية الفكرية وإمكانية دراسة النموذج دون اتصال لتطوير هجمات أكثر استهدافًا.
يسمح استدلال العضوية للمهاجمين بتحديد ما إذا كانت سجلات بيانات معينة ضمن مجموعة التدريب بدرجات متفاوتة من الثقة، بحسب بنية النموذج ونظام تدريبه. وينشأ عن ذلك خطر على خصوصية المؤسسات التي دربت نماذج على معلومات شخصية.
تتلاعب المدخلات الخصومية بمخرجات النموذج عبر اضطرابات مصممة بعناية. دُرست هذه التقنية أكثر في تصنيف الصور، لكنها تنطبق أيضًا على النص والصوت والأنظمة متعددة الوسائط. إذا اتخذ الذكاء الاصطناعي قرارات بشأن كشف الاحتيال أو الجدارة الائتمانية أو التصوير الطبي أو الدخول المادي، فالمتانة الخصومية خاصية أمنية يجب اختبارها لا الاكتفاء بتوثيقها.
يستحق تسرب البيانات عبر أنظمة الذكاء الاصطناعي اهتمامًا مباشرًا. تكشف منظومات RAG مستندات من قاعدة المعرفة أحيانًا لمستخدمين لا يحق لهم الاطلاع عليها. ويكشف تسرب الموجّه من تعليمات النظام تفاصيل تشغيلية أردت إبقاءها سرية. وتتطلب عمليات النشر متعددة المستأجرين عزلًا قد يقلل مهندسو أمن التطبيقات التقليدي أحيانًا من أهميته. هذه مخاطر تشغيلية تظهر باستمرار في الأنظمة المنشورة.
يغير وكلاء الذكاء الاصطناعي سطح الهجوم بالكامل
كُتبت معظم شهادات أمن الذكاء الاصطناعي عندما كانت أنظمة الذكاء الاصطناعي تعني أساسًا روبوتات المحادثة والمصنفات. وفي 2026، أصبح الذكاء الاصطناعي المؤسسي يعني الوكلاء بصورة متزايدة.
يختلف الوكلاء عن روبوتات المحادثة في نقطة تشغيلية مهمة: إنهم يتخذون إجراءات. فالوكيل الذي يصل عبر الأدوات إلى البريد الإلكتروني وقواعد البيانات الداخلية وأنظمة الملفات والمتصفح وبيئات تنفيذ الشيفرة ليس روبوت محادثة بميزات إضافية. إنه عملية مستقلة ذات وصول كبير إلى أنظمة حقيقية، وتعمل بناءً على مخرجات نموذج اللغة.
تدير OWASP الآن Agentic AI Top 10 منفصلًا لأن نموذج تهديد الوكلاء يختلف بما يكفي عن تطبيقات محادثة LLM لتوثيقه بصورة مستقلة.
لا ينتج حقن الموجّه في سياق الوكيل إجابة نصية غير مرغوبة، بل إجراءً غير مرغوب. قد تطلب تعليمات غير مباشرة داخل مستند مسترجع من الوكيل حذف ملفات أو تسريب بيانات أو إرسال رسائل بريد. والنتيجة ليست إجابة غير مناسبة، بل إجراء غير مصرح به ضد أنظمة يستطيع الوكيل الوصول إليها.
يشمل سطح هجوم الوكلاء:
- حدود استدعاء الأدوات: هل يقتصر الوكيل على أقل مجموعة أدوات ملائمة لكل مهمة؟
- نطاق بيانات الاعتماد: هل تقتصر بيانات اعتماد الوكيل على ما تحتاجه كل مهمة؟
- قابلية عكس الإجراءات: هل تتطلب الإجراءات المهمة موافقة بشرية قبل التنفيذ؟
- تصفية المخرجات: هل يجري التحقق من مخرجات الوكيل قبل أن تطلق إجراءات لاحقة؟
- العزل: هل تمنع بيئة تنفيذ الوكيل الوصول غير المقصود إلى الأنظمة المتصلة؟
لا تغطي معظم شهادات حوكمة الذكاء الاصطناعي تصميم أمن الوكلاء بهذا القدر من التحديد.
ينشئ Model Context Protocol سطح هجوم مؤسسيًا جديدًا
أصبح Model Context Protocol (MCP) معيارًا واسع الاستخدام لربط وكلاء الذكاء الاصطناعي بأدوات ومصادر بيانات وخدمات خارجية. تكشف خوادم MCP إمكانات يكتشفها الوكلاء ويستخدمونها. التكامل سريع ومرن، لكن الآثار الأمنية لا تحظى دائمًا باهتمام مماثل.
تشمل المخاطر الخاصة بـ MCP:
- خوادم MCP ضارة تحرف وصف قدراتها على الوكيل وتنفذ إجراءات غير مقصودة
- تسميم الأدوات، إذ يعيد خادم MCP شرعي بيانات يتحكم فيها مهاجم ويضمّن تعليمات في مخرجات يفترض أن تكون بيانات فقط
- أدوات مفرطة الصلاحيات، إذ تمتلك تكاملات MCP صلاحيات تتجاوز ما تتطلبه المهمة
- التباس حدود الثقة، إذ يتلقى الوكلاء تعليمات من أدوات MCP متصلة تبدو مساوية لتعليمات المستخدم
تحتاج المؤسسات التي تنشر وكلاء مع تكاملات MCP إلى إطار لتقييم الثقة بخوادم MCP، وتدقيق صلاحيات الأدوات، والتحقق من أن استجابات الأدوات تعامل كبيانات لا كتعليمات.
التقييم هو الممارسة التشغيلية التي تتجاهلها الشهادات
يحل اختبار الفريق الأحمر للذكاء الاصطناعي ومجموعات التقييم تدريجيًا محل التقييمات الأمنية الثابتة بوصفهما الأسلوبين الأساسيين لفهم مخاطر النماذج قبل النشر وبعده.
يشمل اختبار الفريق الأحمر للذكاء الاصطناعي:
- اختبارًا خصوميًا منظمًا لسلوك النموذج أمام تقنيات هجوم معروفة
- قياسًا معياريًا لكسر الحماية على مجموعات بيانات معروفة لهجمات الموجّه
- اختبار المتانة الخصومية لقياس تغير المخرجات تحت مدخلات معدلة
- اختبار تراجع السلوك بين إصدارات النموذج
- تقييم معايير السلامة باستخدام مجموعات تقييم منشورة
توصي NIST وAnthropic وOpenAI وMicrosoft وGoogle وCISA جميعًا باختبار فريق أحمر خاص بالذكاء الاصطناعي قبل نشر الأنظمة عالية المخاطر. وأصبح ذلك توقعًا معياريًا لا ممارسة اختيارية.
لا تهيئ أي من شهادات حوكمة الذكاء الاصطناعي الحالية الممارسين بما يكفي لتحديد نطاق اختبار فريق أحمر ضد نموذج أو وكيل منشور أو تنفيذه أو تفسيره. فهي تصف معنى اختبار الفريق الأحمر، لكنها لا تعلمك كيفية إجرائه.
قابلية رصد الذكاء الاصطناعي مجال مستقل
لا تنتقل سجلات الأمن التقليدية مباشرة إلى أنظمة الذكاء الاصطناعي. تتطلب مراقبة LLM أو وكيل في الإنتاج جمع بيانات مختلفة وتحليلًا مختلفًا.
تشمل بنية قابلية رصد الذكاء الاصطناعي:
- قياسًا عن بُعد للموجّهات والمخرجات لكشف الشذوذ ومخالفات السياسات
- سجلات استدعاء الأدوات لدى الوكلاء، بما فيها الأدوات المستدعاة والوسائط المستخدمة
- مراقبة جودة الاسترجاع في منظومات RAG
- كشف محاولات كسر الحماية وتصنيفها
- مراقبة اتساق المخرجات لاكتشاف انجراف النموذج بين الإصدارات
- تتبع معدل الهلوسة في التطبيقات التي تتطلب دقة واقعية
- أنماط زمن الاستجابة التي قد تشير إلى محاولات حقن موجّه لتضخيم حجم السياق
هذا مجال ناشئ. في 2026، تمتلك معظم المؤسسات التي تنشر الذكاء الاصطناعي قابلية رصد لمكوناته أقل بكثير من قابلية رصد بنيتها التقليدية. ولا تصف معظم شهادات الحوكمة الشكل المناسب لقابلية رصد أنظمة الذكاء الاصطناعي.
الاستجابة لحوادث الذكاء الاصطناعي تختلف عن الاستجابة التقليدية
عند اختراق نظام تقليدي، يغطي دليل IR الاحتواء والتحليل الجنائي والتعافي. وتطرح حوادث الذكاء الاصطناعي أسئلة لا يعالجها الدليل المعتاد.
أعد أدلة للأسئلة التالية قبل أن تحتاج إليها:
- كيف تحدد ما إذا كان نموذج قد سُمم أثناء الضبط الدقيق؟
- كيف تقيّم ما إذا أسيء استخدام استرجاع RAG لإعادة محتوى يتحكم فيه مهاجم؟
- كيف تعرف ما إذا نفذ وكيل إجراءات غير مصرح بها وما نطاقها؟
- كيف تتحقق من أن تحديث نموذج من مورّد خارجي غيّر السلوك بطرق مؤثرة أمنيًا؟
- كيف تحدد سلوك النموذج قبل حادثة لمقارنته بسلوكه بعدها؟
تتطلب هذه المسائل استعدادًا قبل الحادثة، وسجلات وقياسًا عن بُعد معدّين مسبقًا، وأدلة استجابة خاصة بالذكاء الاصطناعي تخصص مساحة للتحليل الجنائي لسلوك النموذج، لا لحركة الشبكة وسجلات نقاط النهاية فقط.
مشكلة تحديث الشهادات
أحد الأسباب البنيوية لتأخر الشهادات عن الممارسة هو أن أمن الذكاء الاصطناعي يتغير أسرع مما تسمح به دورات تحديث الشهادات.
تغطي Security+ وCISSP وISO 27001 مجالات تتطور على مدى سنوات. وتظل أسطح الهجوم الأساسية للشبكات ونقاط النهاية والتطبيقات مستقرة نسبيًا. أما تقنيات هجوم الذكاء الاصطناعي فتتطور خلال أشهر. تختلف تقنيات حقن الموجّه وأساليب الهجوم الخصومي وأسطح هجوم الوكلاء في 2026 عن تلك الموجودة عند إطلاق أول شهادات الذكاء الاصطناعي في 2023 و2024.
تحدث هيئات الشهادات موادها وفق جداول زمنية. نشر OWASP LLM Top 10 مراجعة مهمة خلال عامه الأول. لم يكن MCP مصدر قلق مؤسسيًا عندما صُممت شهادات ذكاء اصطناعي كثيرة حاليًا. وظهرت أطر أمن الذكاء الاصطناعي الوكيلي بعد معظم المناهج الحالية.
هذه مشكلة بنيوية وليست إخفاقًا في النية. اقرأ المصادر الأولية باستمرار بدلًا من اعتبار الشهادة رصيدًا معرفيًا ثابتًا.
ما ينبغي أن تتضمنه شهادات أمن الذكاء الاصطناعي
لكي تعكس المناهج ممارسات أمن الذكاء الاصطناعي الحالية، ينبغي أن تغطي:
- الدفاع متعدد الطبقات ضد حقن الموجّه: تصفية المدخلات والتحقق من المخرجات وتحديد نطاق الأدوات والعزل وبوابات الموافقة البشرية، إلى جانب الحدود الموثقة لكل منها
- التحقق من سلسلة توريد النماذج: مخاطر التسلسل غير الآمن ومتطلبات SBOM وتوثيق المنشأ والتحقق من القطع الموقعة
- بنية أمن وكلاء الذكاء الاصطناعي: حدود الثقة، وأقل صلاحية للأدوات، وقابلية عكس الإجراءات، ومتطلبات المراقبة
- أمن MCP والتكاملات الخارجية: تقييم الثقة بخوادم الأدوات وتدقيق صلاحياتها وفصل البيانات عن التعليمات
- التقييم واختبار الفريق الأحمر: كيفية تحديد نطاق تقييم خصومي، والمعايير ومجموعات بيانات التقييم الموجودة، وكيفية تفسير النتائج
- قابلية رصد الذكاء الاصطناعي: السجلات والقياس عن بُعد اللازمان وكيفية استخدامهما لكشف الحوادث والاستجابة لها
- الاستجابة الخاصة بحوادث الذكاء الاصطناعي: التخطيط المسبق للسيناريوهات وجمع الأدلة المتعلقة بسلوك النماذج واعتبارات التعافي الخاصة بها
- منع تسرب البيانات: عزل RAG وسرية الموجّه وضوابط الوصول متعددة المستأجرين وتصفية المخرجات
ما ينبغي فعله الآن
إذا كنت مسؤولًا عن أنظمة الذكاء الاصطناعي في مؤسستك:
اقرأ OWASP Top 10 for Large Language Model Applications وOWASP Agentic AI Top 10. فهما مجانيان وأكثر تحديدًا من الناحية التشغيلية من مناهج الشهادات المدفوعة الحالية.
راجع MITRE ATLAS قبل جلسة نمذجة التهديد التالية لأي مكون ذكاء اصطناعي. اعرف تكتيكات الخصم التي تنطبق على بنيتك قبل إكمال تصميم النشر.
اقرأ NIST AI 600-1. فهو يوسع AI RMF الأساسي خصيصًا للذكاء الاصطناعي التوليدي، وهو أكثر صلة بكثير بنشر LLM والوكلاء من الإطار الأساسي وحده.
راجع Google SAIF وMicrosoft’s AI SDL وOWASP AI Exchange للحصول على الإرشادات الهندسية التي لا توفرها أطر الحوكمة.
تحقق من مصدر كل نموذج تنشره مؤسستك. افحص بطاقات النماذج. امسح صيغ التسلسل بحثًا عن فئات استغلال معروفة قبل تحميل الأوزان.
اربط كل وكيل ذكاء اصطناعي في بيئتك بصلاحيات الوصول التي يملكها. فالوكيل الذي يمتلك صلاحية القراءة والكتابة في قاعدة المعرفة الداخلية والبريد الإلكتروني ونظام الملفات يضخم أثر حقن الموجّه. قلص بيانات اعتماده إلى ما تحتاج إليه كل مهمة.
اشترط اختبار فريق أحمر خاصًا بالذكاء الاصطناعي قبل نشر أي نموذج أو وكيل في سياق عالي العواقب. اعتبره إلزاميًا لا اختياريًا.
أنشئ الآن أدلة استجابة لحوادث خاصة بالذكاء الاصطناعي قبل أن تحتاج إليها.
اعتبر شهادة الحوكمة توثيقًا لطبقة العمليات. فهي لا توثق وضعك الأمني.
المراجع
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation
Related Posts