داخل أسطولنا الهجين لوكلاء الذكاء الاصطناعي: Hermes وLiteLLM وTailscale

Table of Contents
نشرنا أسطول GPU محليًا يخصص الموارد لكل طلب، وصممنا مستوى تحكم هجينًا له. يبدأ المسار المتحقق منه في LiteLLM، ثم يختار مجموعة نماذج ويحمّل نموذجًا محليًا على GPU واحد في كل مرة. سياسة مستويات Hermes مقترحة، كما أن عنصر إعداد Tailscale Aperture جاهز لاختبار التكامل التالي. لم يُتحقق من أي منهما بوصفه جزءًا من مسار متكامل من البداية إلى النهاية.
تُعدّن البطاقات الخاملة Pearl. يوقف طلب الذكاء الاصطناعي التعدين على البطاقة المستأجرة وحدها، ويعالج الطلب، ويفرغ النموذج، ثم يعيد البطاقة إلى برنامج التعدين.
أهم النقاط
- تتولى المستويات T0 إلى T2 الأعمال المكلفة أو الصعبة. تفضّل هذه المسارات النماذج السحابية المتقدمة وسلاسل الرجوع المرتبة.
- يتولى T3 الأعمال المحلية الكبيرة. يوزع الأسطول التخطيط والبرمجة والمراجعة والرؤية على نماذج من 4B إلى 12B.
- يتولى T4 الأعمال المحلية كثيرة التكرار. توجه النماذج الصغيرة الطلبات وتصنف البيانات وتستخرجها وتنتج التضمينات وتنجز مهام برمجية محدودة.
- كل GPU مورد مستقل. تخدم بطاقة واحدة مهام الذكاء الاصطناعي بينما تواصل البطاقات الأخرى التعدين.
- تبقى النماذج المحلية غير محمّلة وقت الخمول. لا يحتفظ أي نموذج بذاكرة GPU بين فترات الطلبات.
- تعرض كل بوابة الكتالوج المنطقي نفسه. توزع الأسماء المستعارة المشتركة العمل على الأنظمة المؤهلة. وتحافظ الأسماء التي تبدأ باسم عقدة على موضع محدد عند الحاجة.
- لم يدخل الوسيط التجريبي مرحلة الإنتاج. خدم اختباره المحدود طلبًا، ثم أخفق في اختبار الإيقاف السليم. ظل LiteLLM على المسار المتحقق منه لكل طلب.
- ما زال Hermes وAperture في مرحلة الإعداد. التصميم المستهدف قائم، لكن اختبار القبول الشامل لم يكتمل.
المتطلبات المسبقة: عدة مضيفات Linux مزودة بوحدات GPU، وبرامج تشغيل NVIDIA مستقرة، وشبكة Tailscale خاصة، وsystemd، وبرنامج تعدين عامل، وتخزين للنماذج، واختبارات قبول لكل مسار نموذج.
الوقت والصعوبة: متقدم. خصص عدة أيام لجرد الأجهزة، وتنزيل النماذج، وتعريف الخدمات، واختبارات التوجيه، وتدريبات الأعطال، وفحوص استعادة التعدين لكل بطاقة.
مصطلحات مستخدمة أدناه: شبكة Tailscale الخاصة هي الشبكة الخاصة التي تشكلها هويات وأجهزة Tailscale. الاسم المستعار للنموذج اسم ثابت للنموذج يظهر للعملاء. مجموعة النماذج تضع عدة عمليات نشر خلف اسم مستعار واحد. وسيط المجموعة خدمة محلية صغيرة تستأجر GPU، وتشغّل عامل النموذج، ثم تعيد البطاقة إلى التعدين.
هدف التصميم
تأتي أعمال الوكلاء بأشكال متعددة. يحتاج إصلاح مستودع برمجي إلى نموذج يختلف عن النموذج المناسب لعنوان أو لقطة شاشة أو تضمين أو وسم للنية. إرسال كل دور إلى أكبر نموذج يهدر المال والسعة المحلية. وإرسال كل دور إلى أصغر نموذج يسبب إعادة المحاولة ويضعف النتائج.
أردنا كتالوجًا واحدًا بخمسة مستويات لأحمال العمل. كان على السياسة تقديم النماذج السحابية والمحلية عبر صيغ API مألوفة. كما أردنا إبقاء وحدات GPU المحلية منتجة بين طلبات الذكاء الاصطناعي.
احتاج الأسطول أيضًا إلى العمل المتزامن. ينبغي للمضيف ذي البطاقات المتعددة أن يخدم عدة مهام مستقلة في الوقت نفسه. ويجب ألا يوقف طلب على بطاقة واحدة التعدين على جميع بطاقات الهيكل.
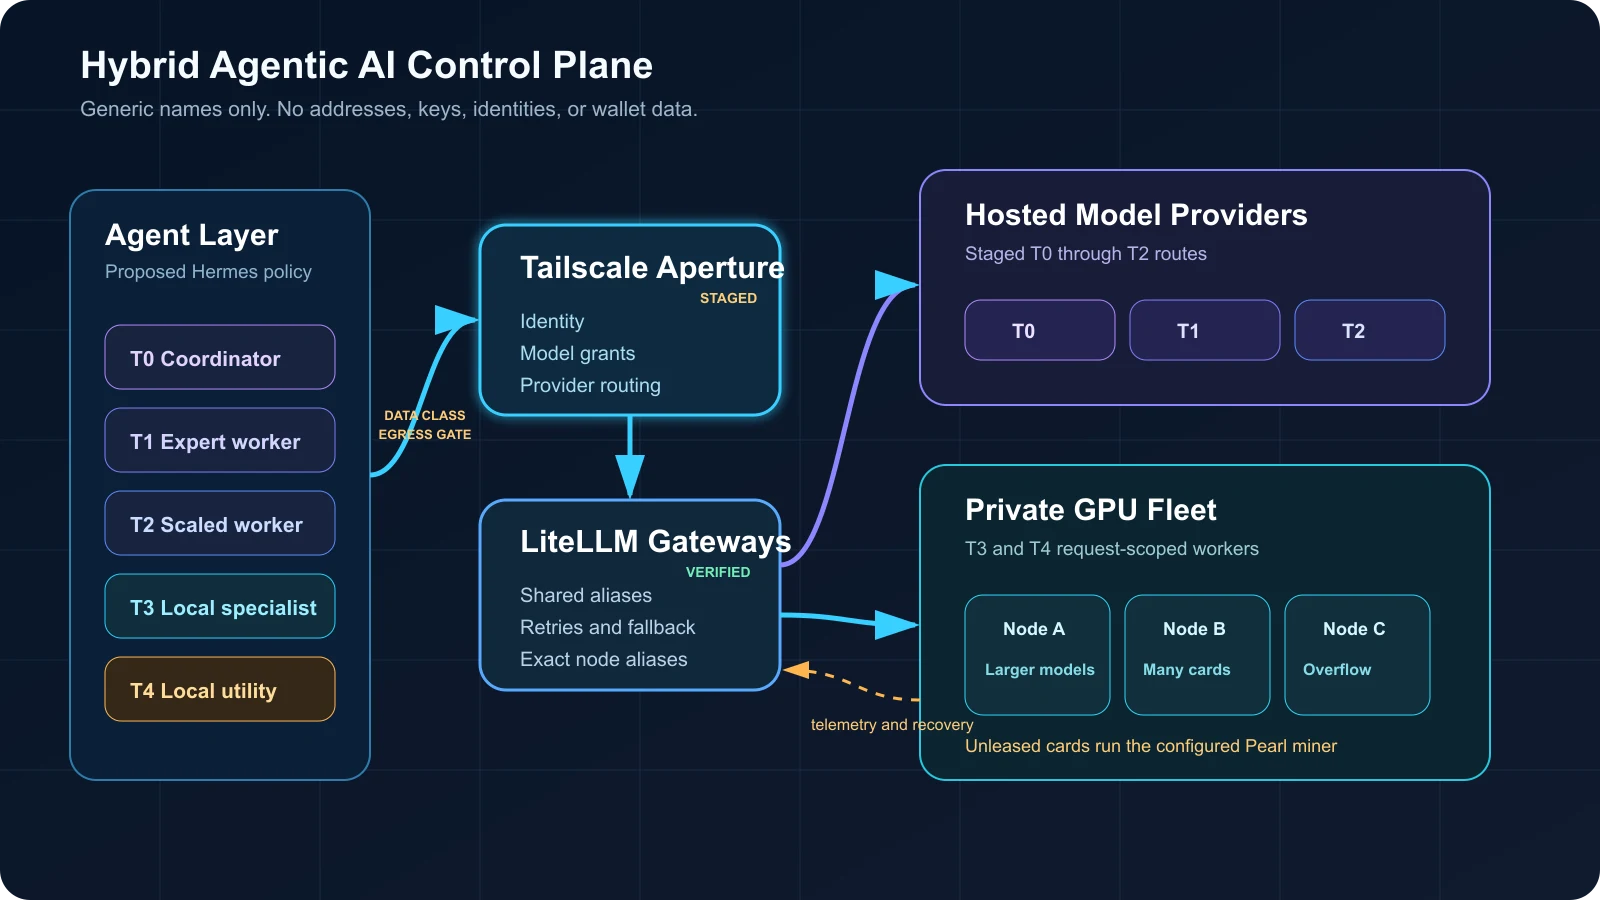
يقع مسار التحكم المقترح وقيد الإعداد فوق مسار التنفيذ المتحقق منه في LiteLLM وعلى مستوى كل GPU
يستخدم المخطط أسماء عقد عامة. ولا يعرض العناوين الخاصة أو هويات المستخدمين أو مفاتيح الوصول أو بيانات المحافظ أو تسميات المضيفات الفعلية.
معنى المستويات T0 إلى T4
أسماء المستويات جزء من سياسة التوجيه لدينا. وهي ليست معيارًا في القطاع ولا تصف حجم النموذج وحده.
| المستوى | الدور الأساسي | الوجهة المعتادة | التصرف عند الفشل |
|---|---|---|---|
| T0 | المنسق الافتراضي وأصعب القرارات | نموذج استدلال سحابي متقدم | سلسلة رجوع سحابية مرتبة |
| T1 | وكلاء عاملون ذوو قيمة عالية | مجموعة نماذج سحابية عالية القدرة | إعادة المحاولة ضمن السلسلة المحددة |
| T2 | مجموعة عامة من العمال | نماذج سحابية سريعة مع إمكانية التصعيد | تصعيد المهام الصعبة إلى T1 أو T0 |
| T3 | أعمال محلية خاصة كبيرة | نماذج دردشة وبرمجة ومراجعة ورؤية محلية من 4B إلى 12B | إعادة المحاولة على عقدة محلية مؤهلة، ثم الرفض الآمن للبيانات المقيدة |
| T4 | أعمال محلية ضيقة النطاق ومتكررة | نماذج محلية للتوجيه والتصنيف والبرمجة والتضمين من 0.6B إلى 3B | إعادة المحاولة على نسخة محلية أو الانتقال إلى T3 ضمن حدود البيانات نفسها |
تصف المستويات المهمة قبل النموذج. يناسب T4 تصنيفًا أمنيًا قصيرًا وحساسًا. وتناسب T3 أو مستوى أعلى خطة طويلة لمستودع برمجي. أما القرار المعماري الصعب فيبدأ بمستوى أعلى حتى لو كان طلبه قصيرًا.
يغير هذا التقسيم أيضًا اقتصاديات الوكلاء. تتولى وحدات T4 التحويلات المتكررة منخفضة المخاطر. وتحفظ وحدات T3 الأعمال البرمجية والتحليلات الشائعة داخل شبكة Tailscale الخاصة. وتظل T0 إلى T2 متاحة للأعمال الصعبة والتعافي من الأعطال.
يجب أن يسبق فحص فئة البيانات كل رجوع إلى نموذج مستضاف. تحصل الأعمال العامة والداخلية والمقيدة على سلاسل منفصلة. وتبقى الأعمال المقيدة محلية، مع الرفض الآمن عند الفشل. تتطلب إعادة المحاولة العابرة لحدود البيانات إدخالًا منقحًا وموافقة صريحة من المستخدم أو سير العمل. ويحذف التنقيح بيانات الاعتماد وأسرار المستودع ومخرجات الأدوات الخاصة ومحتوى الاسترجاع الحساس قبل أي اتصال مستضاف.
كيف سيتولى Hermes سياسة المهام
Hermes هو طبقة الوكلاء المقترحة. تعيّن السياسة المستهدفة فئة نموذج، وتشغّل الأدوات، وتفوّض العمل، وتتبع سلاسل رجوع صريحة. يوثق Hermes مسارات منفصلة للنموذج الأساسي والمهام المساعدة والوكلاء المفوضين وعمليات الرجوع الخاصة بالمهمة. كما يدعم نقاط نهاية مخصصة متوافقة مع OpenAI عبر عنوان URL أساسي. راجع دليل إعداد Hermes و دليل مزودي الرجوع .
تربط سياستنا مهام Hermes بأسماء مستعارة ثابتة بدلًا من الخوادم الفعلية. ومن أمثلتها:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
يعبر الاسم المستعار عن الغرض. ولا يحتاج Hermes إلى معرفة وحدة GPU المتاحة أو العقدة ذات البطاقة الأكبر أو النسخة التي أخفقت في فحص السلامة. تتولى الطبقات الأدنى هذه القرارات.
ما زالت بعض الأعمال تحتاج إلى تحديد موقع حتمي. يرسل معرّف نموذج يبدأ باسم عقدة تشخيصًا تشغيليًا أو اختبارًا معياريًا إلى نظام محدد. وينبغي أن تقصر أذونات Aperture المنفصلة هذه الأسماء المستعارة على المشغلين. تستخدم حركة الوكلاء المعتادة أسماء مستويات مشتركة.
الوصول إلى النماذج لا يؤمّن أدوات الوكلاء. يحتاج طرح Hermes إلى قوائم سماح للأدوات وفق أقل الصلاحيات، ومساحات عمل معزولة، وبيانات اعتماد محدودة النطاق، وضوابط لاتصالات الشبكة الصادرة، ومعالجة حقن الموجهات. وينبغي ألا يرث العمال المفوضون صلاحيات تتجاوز حاجة المهمة المسندة إليهم.
Aperture حد الهوية قيد الإعداد
يربط Tailscale البوابة المضبوطة ومضيفات الاستدلال من دون نشر كل خدمة على الإنترنت العام. يجري إعداد Aperture ليكون الحد الموجه للمستخدم وموجه النماذج. وما زال هذا المسار يحتاج إلى اختبار قبول شامل. توثق Tailscale وصول العملاء المشفر عبر الشبكة الخاصة وتمرير الطلبات إلى المزود عبر TLS في طريقة عمل Aperture .
يفصل Aperture أيضًا بين إمكانية الوصول والإذن. تكون أذوناته رافضة افتراضيًا. ويحتاج المستخدم أو الجهاز المصنف إلى إذن نموذج مطابق بعد الوصول إلى البوابة. يشرح دليل أذونات Aperture نموذج الأذونات التراكمي ومصادر الهوية.
ينبغي أن يتبع إعداد Aperture قيد التجهيز أربع قواعد قبل النشر:
- تملك هوية مسماة واحدة دور المسؤول. لا تمنح صلاحية الوصول العام إلى النماذج صلاحية الإدارة.
- تسرد المزودات معرّفات النماذج حرفيًا. لا يستنتج Aperture النماذج من خدمة upstream.
- تشير عناوين URL للمزودات إلى عناوين الشبكة الخاصة. تبقى أسماء العقد الخاصة وعناوينها خارج المقال وأمثلة الإعداد العامة.
- تبقى الأسرار في ملفات تملكها الخدمة. طبّق أذونات للمالك وحده، وحسابات خدمة مقيدة، وتدويرًا للأسرار، وتنقيحًا للسجلات قبل النشر. يجب ألا تطبع مخرجات التشخيص مفاتيح LiteLLM أو عناوين الشبكة الخاصة أو رموز الاشتراك أو بيانات المحافظ.
يضيف Aperture مسار الطلب الوارد إلى عنوان URL الأساسي لكل مزود. ويحذر
مرجع الإعداد
من وضع لاحقة /v1 مكررة في جذر المزود. تسبب هذا التفصيل بمخاطر تكامل كافية لإضافة فحص تحقق صريح.
أُعد مسار الرؤية للعمل عبر تنسيق OpenAI Chat Completions مع محتوى الصور. وتستخدم التضمينات نقطة نهاية LiteLLM الخاصة مباشرة، لأن مصفوفة مزودات Aperture المستضافة ذاتيًا توثق تنسيقات الدردشة، بينما يعتمد مسار التضمين لدينا على نقاط نهاية LiteLLM وllama.cpp خارج محدد الدردشة. راجع مرجع المزودات والعملاء المدعومين .
يحتاج مسار التضمين المباشر إلى حد تفويض خاص به. ينبغي أن يقيد الوصول بهويات أو وسوم خدمة معتمدة كل من مصادقة LiteLLM وأذونات Tailscale الصارمة وربط الخدمة بواجهة الشبكة الخاصة وقواعد جدار الحماية للمضيف. العنوان الخاص وحده لا يشكل سياسة تفويض.
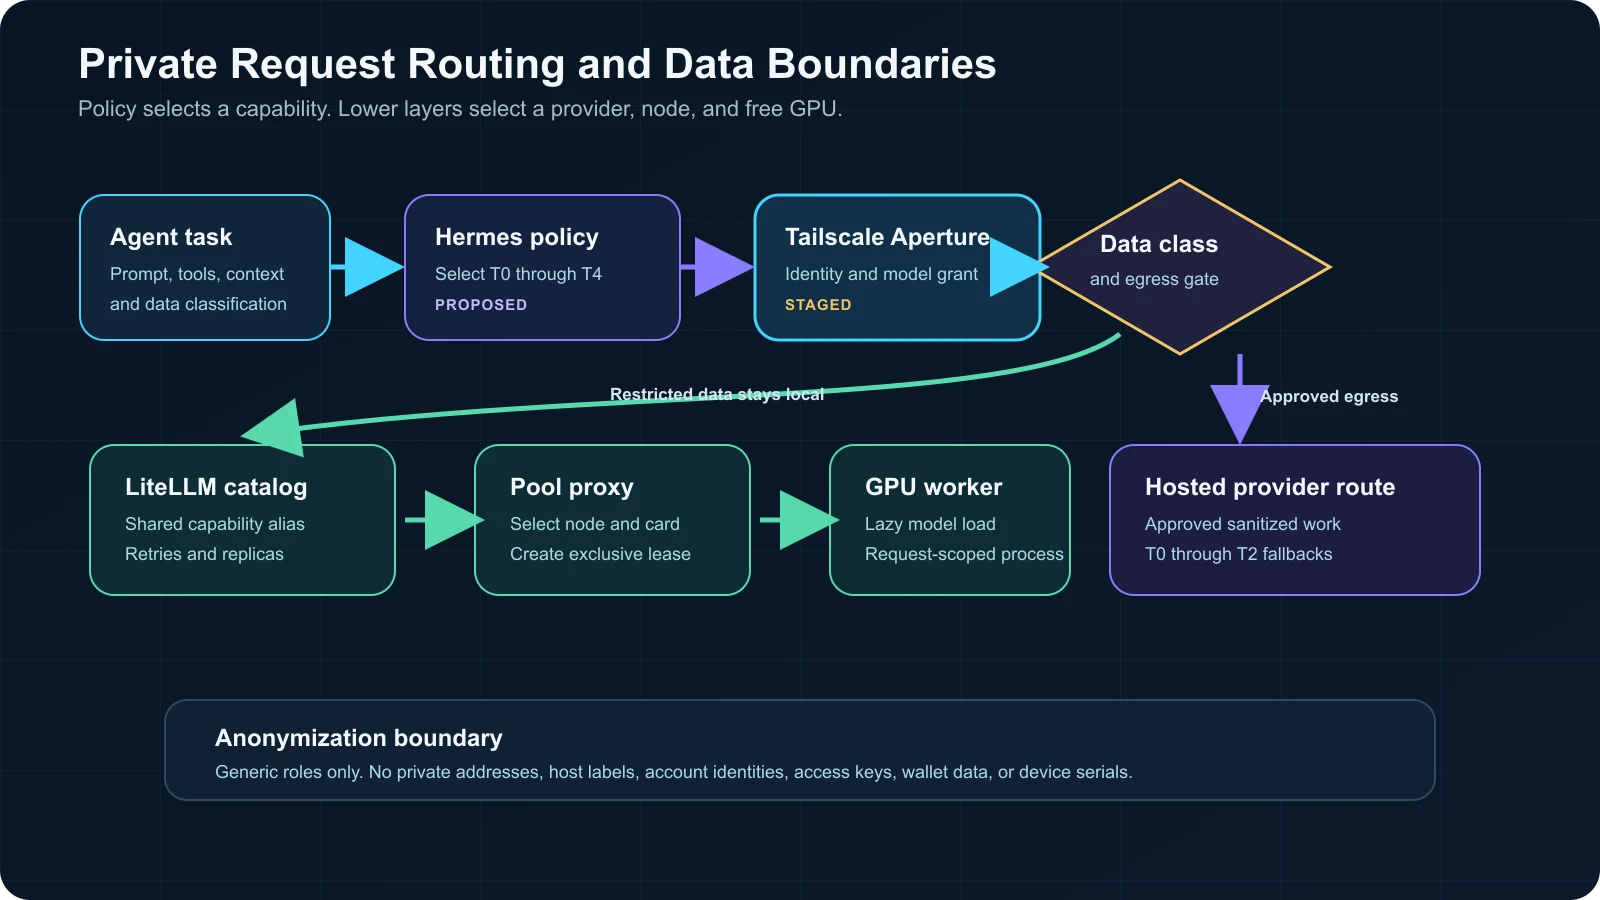
تحدد الهوية والأذونات وتصنيف البيانات ما إذا كان الطلب سيغادر الأسطول الخاص
يقدم LiteLLM كتالوجًا واحدًا
تشغّل كل عقدة استدلال بوابة LiteLLM. وتعرض كل بوابة كتالوج النماذج المنطقي نفسه حتى عندما يكون النموذج على عقدة أخرى. ويحتفظ العميل بصيغة API واحدة ومجموعة أسماء مستعارة واحدة.
يجمع LiteLLM عدة عمليات نشر تحت اسم نموذج واحد. ثم يختار الموجه عملية نشر مؤهلة ويطبق إعادة المحاولات والمهل وفترات التهدئة أو الرجوع. توضح وثائق توجيه LiteLLM الحالية أسماء النماذج المشتركة واستراتيجيات التوجيه وسلوك إعادة المحاولة.
يضم الكتالوج طريقتين للعناوين:
| طريقة العنوان | المثال | الاستخدام |
|---|---|---|
| اسم مستعار مشترك | t4-classify | توزيع العمل المعتاد على العقد المؤهلة |
| اسم مستعار للعقدة | node-b/qwen-small | إجراء التشخيص أو الحفاظ على الموقع المحدد |
توفر الأسماء المستعارة المشتركة توسعًا أفقيًا من دون تغيير Hermes. تؤدي إضافة نسخة مؤهلة إلى توسيع مجموعة النماذج. ويؤدي حذف نسخة غير سليمة إلى تضييق المجموعة.
نبقي منطق دورة حياة GPU أسفل LiteLLM. تظل البوابة دافئة لأن بصمتها الذاكرية لا تحجز ذاكرة GPU. يستقبل وسيط مجموعة محلي طلب النموذج المختار، ويستأجر بطاقة، ويبدأ العامل، ثم ينهيه بعد الرد.
كتالوج النماذج المحلية
يفضل الأسطول النماذج التي لا تتجاوز 12B معلمة. يناسب هذا الحد ذاكرة البطاقات المتاحة مع ترك مساحة للسياق ومخازن وقت التشغيل.
ترميز النماذج: يرمز B إلى مليارات المعلمات. ويرمز K إلى آلاف رموز السياق المضبوطة. التكميم يخزن أوزان النموذج بدقة رقمية أقل لتقليل استهلاك الذاكرة. ويحتفظ مخبأ KV بحالة الانتباه للسياق النشط وينمو مع طول الموجه. E4B تسمية Google للنسخة الأصغر من Gemma 4.
| مسار المستوى | فئة النموذج | السياق المضبوط | المهمة الأساسية | الموقع |
|---|---|---|---|---|
| T3 الذكي | Qwen3.5 9B، مكمّم | 64K | التخطيط المحلي الصعب وعمل الوكلاء العام | عقد GPU ذات ذاكرة أكبر |
| T3 للبرمجة | Granite 4.2 8B، مكمّم | 64K | أعمال المستودعات والأدوات والمهام الطرفية والمخرجات المنظمة | عقد GPU ذات ذاكرة أكبر |
| T3 للمراجعة | Gemma 4 12B، مكمّم | 32K | مراجعة مستقلة واستدلال بديل | عقد GPU ذات ذاكرة أكبر |
| T3 العام والرؤية | Qwen3.5 4B، مكمّم | 32K | أعمال عامة موسعة وفهم الصور | كل وحدات GPU المتوافقة |
| T3 للمراجعة البديلة | Gemma 4 E4B، مكمّم | 8K | مسار مراجعة متنوع | كل وحدات GPU المتوافقة |
| T4 للبرمجة | Granite 4.2 3B، مكمّم | 16K | تعديلات صغيرة واستدعاء الأدوات ومخرجات منظمة | كل وحدات GPU المتوافقة |
| T4 للتصنيف | Qwen3.5 2B، مكمّم | 16K | التصنيف والاستخراج وإعادة الصياغة | كل وحدات GPU المتوافقة |
| T4 للتوجيه | Qwen3.5 0.8B، تكميم عالي الدقة | 16K | النية والتسميات والعناوين والتحويلات القصيرة | كل وحدات GPU المتوافقة |
| T4 للتضمين | Qwen3 Embedding 0.6B، مكمّم | 32K | ذاكرة الوكلاء وRAG واسترجاع الشيفرة والتجميع | كل وحدات GPU المتوافقة |
هذه القيم للسياق إعدادات للنشر وليست حدود النماذج المعلنة. تستهلك النافذة المعلنة الأكبر مخبأ KV وذاكرة وقت التشغيل أيضًا. اخترنا قيمًا أقل لتوفير خدمة مستقرة على بطاقة واحدة.
تصف Qwen مجموعة Qwen3.5 بأنها متعددة الوسائط وتنشر نسخًا كثيفة صغيرة وأكبر ضمن مجموعة Qwen3.5 . وتنشر IBM نتائج البرمجة الوكيلة والسياق الطويل لـ Granite 4.2 8B . وتشير Google إلى أن Gemma 4 يدعم المدخلات متعددة الوسائط واستدعاء الدوال ونافذة معلنة أكبر.
يستخدم مسار التضمين نموذجًا منفصلًا بدل طلب المتجهات من نموذج دردشة. تذكر بطاقة نموذج Qwen3 Embedding 0.6B تسلسلًا بطول 32K، واسترجاعًا متعدد اللغات واسترجاع الشيفرة، وأبعاد إخراج تصل إلى 1,024.
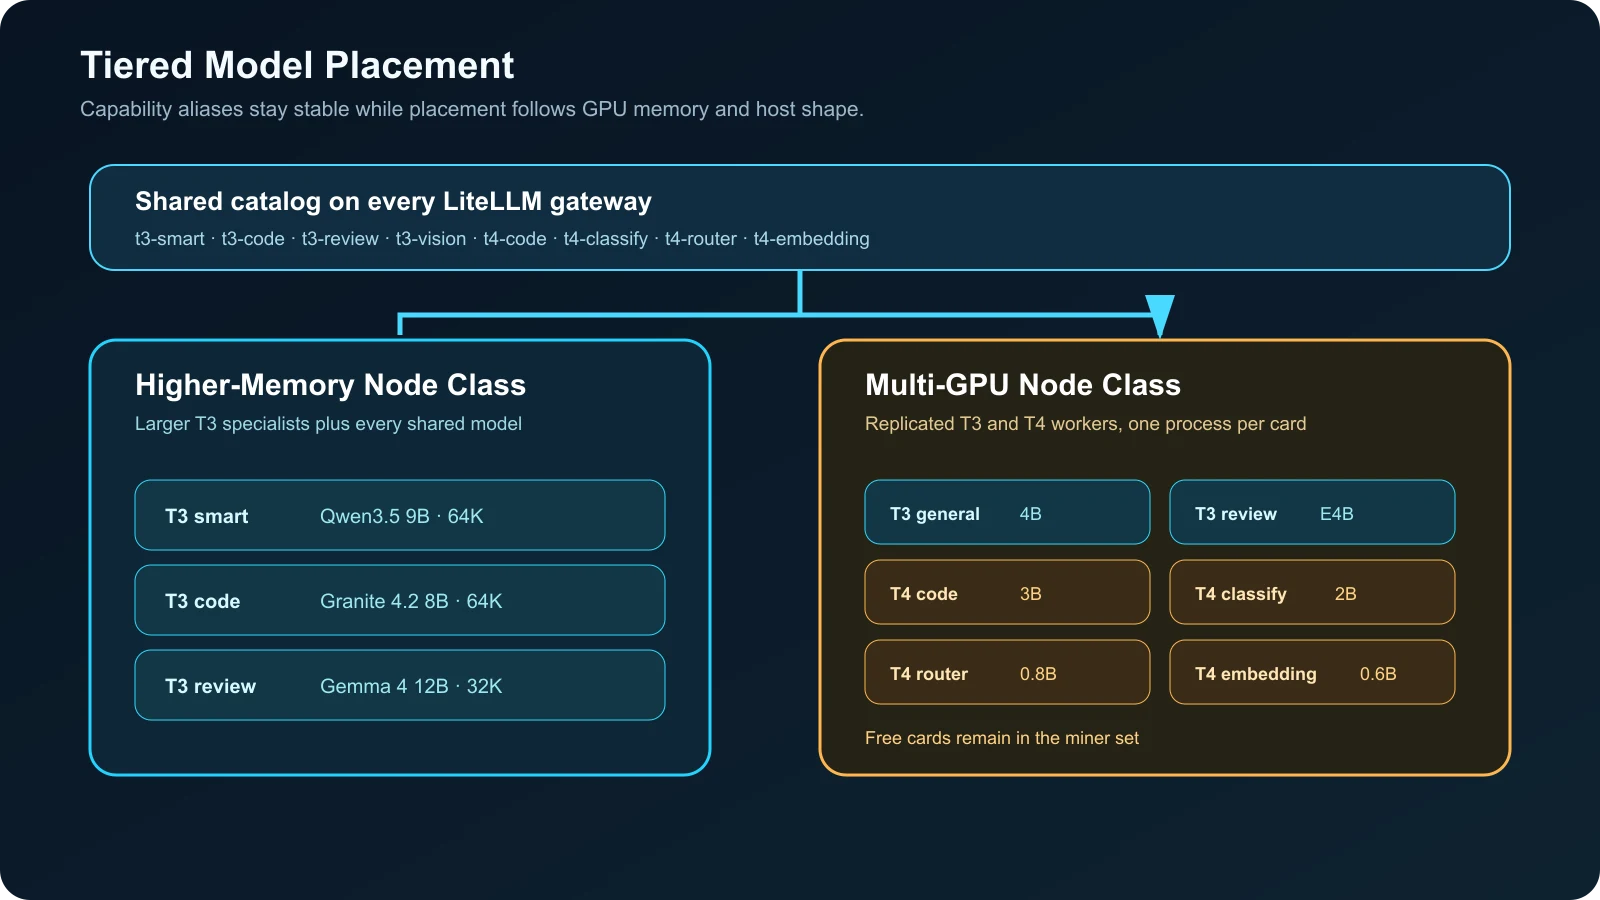
تبقى النماذج المتخصصة الأكبر على البطاقات ذات الذاكرة الكبيرة، بينما تتكرر النماذج الأصغر عبر الأسطول
لماذا يشغّل llama.cpp الإنتاج
يناسب llama.cpp نموذج الموارد. يقابل كل عامل ثابت GPU واحدًا وملف نموذج واحدًا وسياقًا مضبوطًا واحدًا وإيجارًا واحدًا. وتسهل حدود العملية تدقيق بدء التشغيل والإيقاف ورؤية GPU والسجلات.
يعرض خادمه واجهات دردشة وردود وتضمينات متوافقة مع OpenAI. كما يدعم فك الترميز المتوازي والتجميع المستمر. وتصف وثائق الخادم الحالية دعم الوسائط المتعددة بأنه تجريبي. ترد هذه الميزات في وثائق خادم llama.cpp .
يبقى Ollama متاحًا كمسار توافق على عقدة أكبر. يدعم Ollama تحميل عدة نماذج بالتزامن عندما تكفي الذاكرة، والتفريغ الفوري عبر keep_alive: 0، كما توضح
الأسئلة الشائعة لـ Ollama
. لم نختر Ollama لمسار الإنتاج لكل بطاقة لأن عمال llama.cpp الثابتين منحونا تحكمًا أدق بالموقع والإيقاف.
راجعنا Strata أيضًا. يستهدف Strata نموذج Qwen كبيرًا بمزيج الخبراء موزعًا بين ذاكرة GPU وذاكرة RAM للنظام والتخزين. تبدأ الإعدادات المسبقة المنشورة بذاكرة إجمالية قدرها 32 GB، بينما يبادل وضع الذاكرة المنخفضة السرعة بسعة أقل. راجع مستودع Strata . يناسب Strata هدفًا مختلفًا: نموذج هجين أكبر عبر بطاقة واحدة أو عدة بطاقات. يفضل أسطولنا تشغيل عدد كبير من العمال المستقلين دون 12B.
التحميل الكسول لكل GPU
ينطبق التحميل الكسول على كل عامل نموذج. ولا يبقي النظام نشطًا بين الطلبات إلا البوابات ووسطاء المجموعات ومراقبات السلامة وبرنامج التعدين.
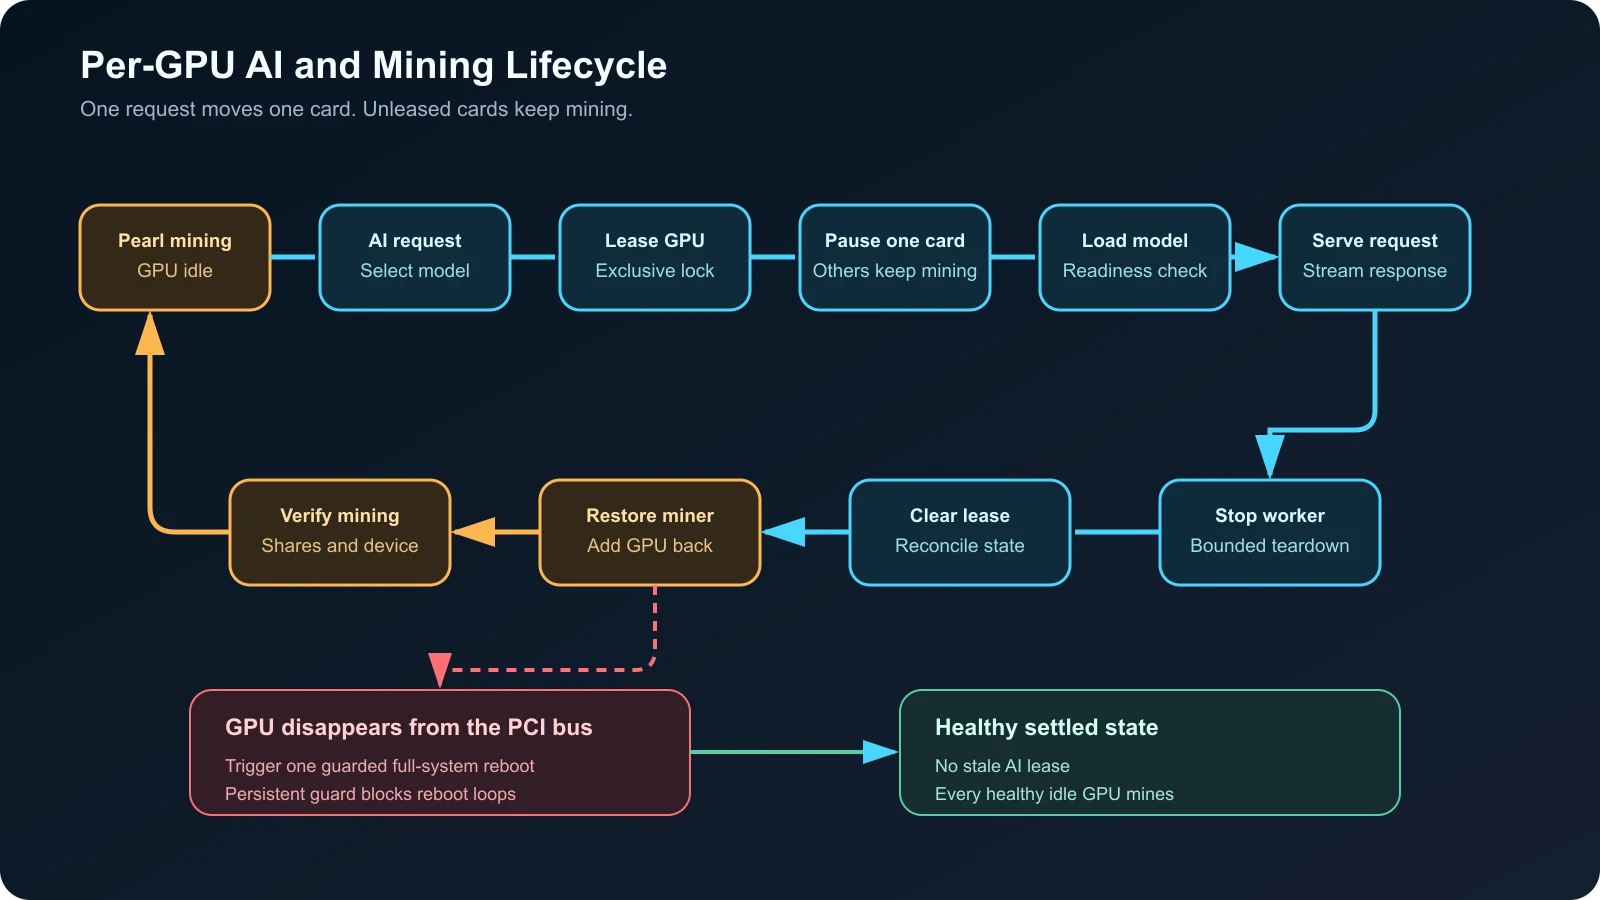
تغادر البطاقة المستأجرة وحدها برنامج التعدين، ثم تعود بعد انتهاء عملية النموذج
تتبع دورة حياة الطلب هذه الخطوات:
- يختار LiteLLM عملية نشر. يصل الطلب إلى وسيط المجموعة الخاص بفئة النموذج المختارة.
- تحصل المجموعة على إيجار. يمنع قفلٌ عاملين حصريين من استخدام البطاقة نفسها.
- يعيد برنامج التعدين التشغيل من دون GPU واحدة. تبقى كل بطاقة غير مستأجرة ضمن أمر Pearl.
- يبدأ llama.cpp على الجهاز المستأجر. تكتمل فحوص الجاهزية قبل تمرير الوسيط للطلب.
- يعالج العامل الرد. تبدأ الطلبات المتزامنة عمالًا على بطاقات أخرى متاحة.
- ينتهي العامل. تحذف المجموعة الإيجار بعد انتهاء العملية.
- يعيد برنامج التعدين التشغيل مع GPU المحررة. تؤكد فحوص السلامة عودة البطاقة إلى التعدين.
يختلف هذا عن تبديل المضيف كله أو لا شيء. يخدم هيكل متعدد البطاقات عدة نماذج بينما تواصل البطاقات المتبقية التعدين. وعندما يخلو الأسطول، تعيد كل وحدة GPU سليمة إلى Pearl.
يصف الكتاب الأبيض لـ Pearl نظام إثباته القائم على حساب المصفوفات. لا تعتمد بنيتنا على توقع للربحية أو ادعاء بعائد اقتصادي. التعدين هو حمل العمل المضبوط وقت الخمول.
معالجة الأعطال أهم من بدء التشغيل
بدء النموذج نصف دورة الحياة فقط. فالإيقاف القسري واختفاء وحدات GPU وانقطاع الطلبات والإيجارات القديمة وإعادة تشغيل برنامج التعدين تحتاج إلى معالجة صريحة.
تقارن مراقبة السلامة مجموعة وحدات GPU المضبوطة بقائمة أجهزة NVIDIA الحية. يؤدي تأكيد اختفاء وحدة GPU إلى إعادة تشغيل واحدة كاملة للنظام مع ضوابط حماية. ينبغي أن يتطلب مشغل الإنتاج الآمن فحوصًا فاشلة متكررة وفترة تهدئة وإنهاء المهام النشطة وعدادًا دائمًا لإعادة التشغيل وتنبيهًا عن بعد. وينبغي أن يوقف فشل استعادة واحد الأتمتة ويتطلب تدخلًا يدويًا.
تطابق مراقبة السلامة نفسها الإيجارات القديمة. إذا لم يملك أي عامل إيجارًا، تحذف المطابقة السجل القديم وتعيد GPU إلى برنامج التعدين. كان مسار الاستعادة هذا مهمًا أثناء الاختبار المحدود للوسيط.
| العطل | الاستجابة |
|---|---|
| يفشل النموذج في فحص الجاهزية | إيقاف العامل، وتحرير الإيجار، واستعادة التعدين، وإرجاع خطأ |
| ينتهي الطلب على نحو غير متوقع | وضع حد زمني للتنظيف، وإنهاء شجرة عمليات العامل، ومطابقة الإيجار |
| تختفي GPU | تأكيد تكرار الاختفاء، وإنهاء الأعمال النشطة، وتنفيذ إعادة تشغيل محمية واحدة، وإرسال تنبيه، ثم التحقق من مجموعة وحدات GPU المضبوطة كاملة |
| يغفل برنامج التعدين بطاقة خاملة | إعادة بناء قائمة الأجهزة من الإيجارات النشطة وإعادة تشغيل برنامج التعدين |
| يفشل نشر LiteLLM | إعادة المحاولة على نسخة أخرى في مجموعة النموذج نفسها، ثم اتباع سياسة الرجوع |
| يمنع إذن Aperture أحد المسارات | إصلاح الهوية أو إذن النموذج، وعدم تجاوز سياسة البوابة مطلقًا |
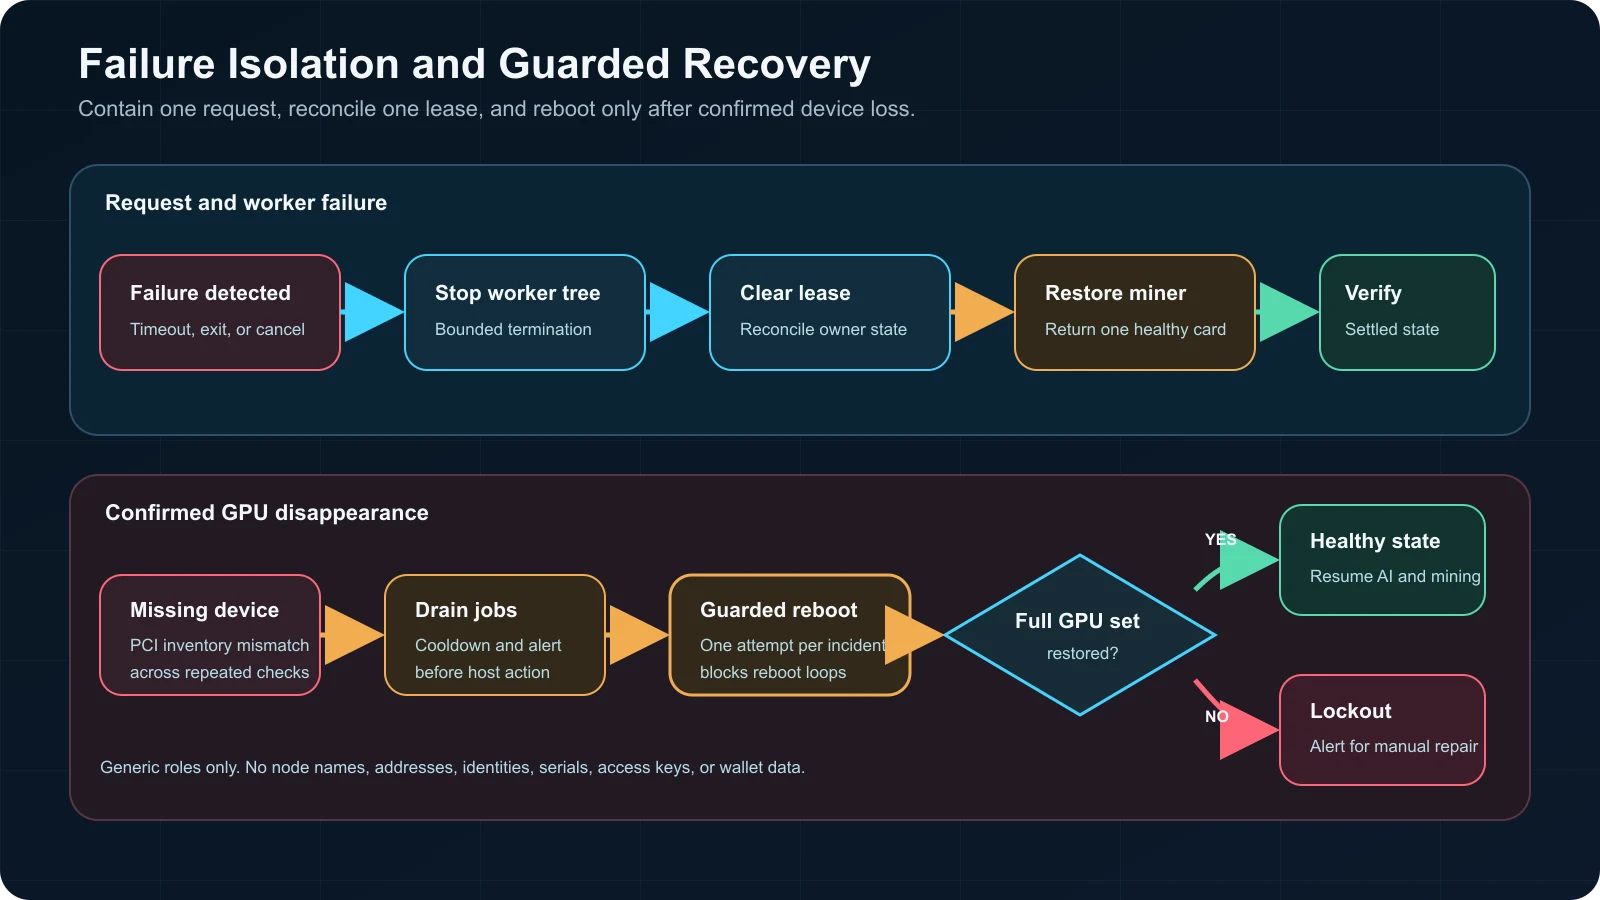
تحرر الأعطال المعتادة إيجارًا واحدًا، بينما يؤدي تأكيد فقد الجهاز إلى مسار استعادة المضيف المحمي
ما حدث مع الوسيط التجريبي
يهدف الوسيط المستقل عن الواجهة الخلفية إلى تقديم واجهة واحدة متوافقة مع OpenAI عبر Ollama وvLLM وllama.cpp وStrata. ويشمل إدارة دورة حياة كل نموذج والتفريغ وقت الخمول وتحديد موقع GPU.
اختبرنا الإصدار 0.6.0 من الوسيط عند الالتزام c12b65 في 21 أكتوبر 2026. أفادت مجموعته المحلية بمرور 1,101 اختبار وتخطي اختبارين، ولم تظهر مشكلات في Ruff. ثم حمّل الاختبار المحدود نموذجًا عند الطلب وخدم طلب دردشة ناجحًا. وواصلت وحدات GPU الأخرى التعدين أثناء الطلب.
كشف الإيقاف مشكلة خطيرة في دورة الحياة. فبعد تحميل نموذج، ظل الوسيط عالقًا في مسار الإيقاف حتى قتل systemd شجرة العمليات. وترك الإيقاف القسري إيجار GPU قديمًا إلى أن أعادت مطابقته التعدين. كما وجدنا فجوة بين إعداد GPU المطلوب الموثق وإنفاذ محول الإنتاج له.
عطّلنا الوسيط في مسار الإنتاج. يوجه LiteLLM الآن الطلبات عبر وسيط المجموعة المخصص لكل طلب. وسيبقى الوسيط تجريبيًا إلى أن تجتاز اختبارات التكامل إيقاف العمليات الفرعية ضمن مهلة، وإنهاء مجموعات العمليات، وفحوص قبول GPU المطلوبة، وتنظيف الإيجارات القديمة.
هذه نتيجة تقدم درسًا هندسيًا مفيدًا. لا يثبت تشغيل النموذج مرة واحدة الكثير عن الوسيط. تعتمد الجاهزية للإنتاج على الإيقاف النظيف والاستعادة محدودة الزمن وقبول الجهاز الحصري وتدريبات الأعطال القابلة للتكرار.
التحقق الذي أجريناه
غطى اختبار النشر ما يتجاوز رد النموذج:
- أكمل كل نموذج دردشة مشترك دورة التحميل والرد والخروج واستعادة Pearl على مضيف مؤهل واحد على الأقل.
- قبل مسار الدردشة مدخل صورة للرؤية.
- أعادت التضمينات حجم المتجه المضبوط عبر مسار LiteLLM الخاص.
- عملت نماذج متعددة في الوقت نفسه على بطاقات منفصلة.
- بقيت البطاقات غير المستأجرة ضمن برنامج التعدين أثناء طلبات الذكاء الاصطناعي المتزامنة.
- وجهت الأسماء المستعارة المشتركة الطلبات عبر العقد المؤهلة.
- حافظت الأسماء التي تبدأ باسم عقدة على تحديد الموقع الحتمي.
- عرضت كل بوابة LiteLLM الكتالوج المنطقي نفسه.
- استعيدت GPU المفقودة بعد إعادة تشغيل كاملة للمضيف. وتحمل مراقبة السلامة الآن حماية دائمة من تكرار الحلقة.
- تعافى فشل إيقاف الوسيط عبر مطابقة الإيجار.
- أظهرت الحالة النهائية المستقرة عدم وجود إيجارات ذكاء اصطناعي وعودة كل GPU سليمة إلى مجموعة التعدين.
لم نعتبر فحوص السلامة وقوائم النماذج اختبارات لتحميل النماذج. يرسل اختبار القبول المفيد طلبًا حقيقيًا، ويفحص الرد، ويؤكد اختيار GPU، ويراقب الإنهاء، ويتحقق من استعادة التعدين.
استكشاف أعطال الأسطول وإصلاحها
| العارض | الفحص الأول |
|---|---|
| يظهر النموذج لكن تفشل الطلبات | معرّف النموذج upstream وصيغة API وترويسة المصادقة وعنوان URL الأساسي للمزود |
| يعيد Aperture الحالة 405 | تحقق من خلو جذر المزود من لاحقة /v1 مكررة |
| تخدم العقدة الخاطئة الطلب | اسم مستعار مشترك مقابل اسم يبدأ باسم العقدة |
| يستهدف عاملان البطاقة نفسها | قفل الإيجار وحالة الإيجار القديم ومنطق قبول GPU |
| يتوقف التعدين على كل بطاقة | تحقق من أن رمز إعادة تشغيل برنامج التعدين يبني قائمة الأجهزة من الإيجارات النشطة |
| تبقى GPU خارج التعدين | شجرة عمليات العامل ومطابقة الإيجارات وقائمة أجهزة برنامج التعدين |
| التحميل البارد بطيء | حجم النموذج وسرعة التخزين وعرض وصلة PCIe وضغط معالج المضيف |
| تفشل الموجهات الطويلة | السياق المضبوط وحيز مخبأ KV وحجز المخرجات |
| مسار التضمين غير موجود في Aperture | استخدم مسار LiteLLM الموثق والمقيد بهوية Tailscale وسياسة جدار حماية المضيف |
| يتوقف الوسيط أثناء الإيقاف | عطّل مسار الوسيط وأعد الحركة إلى وسيط المجموعة المتحقق منه |
قواعد تصميم تستحق الحفاظ عليها
- وجّه حسب غرض المهمة. حجم النموذج وحده لا يحدد المستوى.
- ضع السياسة فوق تحديد الموقع. يختار Hermes اسم قدرة مستعارًا. ويختار LiteLLM عملية نشر. وتختار المجموعة وحدة GPU.
- عامل كل GPU على أنه إيجار منفصل. يهدر التبديل على مستوى المضيف البطاقات المتاحة.
- أفرغ كل نموذج خامل. لا تتطلب البوابات الدافئة عمال GPU دافئين.
- احتفظ بمسار موقع دقيق ومقيد. تجعل أسماء العقد المخصصة للمشغلين التشخيص قابلًا للتكرار.
- اختبر الإنهاء أولًا. تدخل استعادة برنامج التعدين وتنظيف الإيجارات ضمن اختبارات القبول.
- افصل الدردشة والرؤية والتضمينات. لا تعني البوابة الواحدة مسار بروتوكول واحدًا.
- أبق التفاصيل الخاصة خارج المخططات. انشر الأدوار والتدفقات، لا العناوين أو المفاتيح أو الهويات أو بيانات المحافظ.
- أحط منطق إعادة التشغيل بضوابط. اشترط تكرار حالات الغياب وفترة تهدئة وعدادًا دائمًا وتنبيهًا وتدخلًا يدويًا بعد فشل استعادة واحد.
- أبق مسار تجاوز تجريبيًا. يجب ألا يسقط فشل الوسيط المسار المتحقق منه معه.
الخطوات التالية
المرحلة المقبلة هي تقييم أحمال العمل. يحتاج كل مستوى إلى مجموعة مهام ثابتة ومعايير قبول وسجلات زمن الاستجابة وإشغال GPU ومدة توقف التعدين ومعدلات التصعيد. ستبين تلك القياسات أي مهام T2 تناسب T3 وأي مهام T3 تلائم T4.
نخطط أيضًا لتشغيل أول اختبار قبول عبر Hermes ثم Aperture ثم LiteLLM، ثم إعادة اختبار الوسيط بعد إصلاح مساري الإيقاف وقبول GPU. ويتطلب توليد الصور محولًا خاصًا به متوافقًا مع OpenAI ويدعم التحميل الكسول قبل إضافته إلى كتالوج التوجيه نفسه.
لمعرفة كيفية اختيار حجم النموذج، اقرأ دليل سياق نماذج الذكاء الاصطناعي المحلية ووحدات GPU . ولحدود الخصوصية، اقرأ خصوصية الذكاء الاصطناعي المحلي وأمنه . ولإعداد التعدين ومخاطره، راجع دليل تعدين Pearl بدل اعتبار التعدين وقت الخمول ربحًا مضمونًا.
Related Posts